智能体
x.com ·
@meng shao(@shao__meng)
阿里巴巴开源 AI 代码审查工具 Open Code Review:确定性工程与 Agent 混合架构
阿里巴巴将内部打磨两年的 AI 代码审查助手开源为 Go CLI 工具 Open Code Review(命令名 ocr),读取 Git diff 后由 LLM Agent 调用专用工具输出行级审查意见。项目针对通用 Agent 做代码审查的漏审、位置漂移、质量不稳定三大问题,采用多阶段流水线:文件语义分组、风险规划、主审查、独立 Re-location 定位、事实核查过滤与超长会话记忆压缩;Agent 仅挂载 7 个工具,内置 52 份按文件类型 glob 匹配的规则文档,子 Agent 并发审查并带预算控制、指纹去重与断点恢复。项目自建 AACR-Bench(50 个开源仓库、200 个真实 PR、10 种语言、80+ 工程师标注 1505 个问题,数据集公开于 Hugging Face),称相同底层模型下 Precision 与 F1 显著高于通用 Agent、token 消耗约 1/9,但召回率刻意偏低以降低误报。
AI推荐理由
阿里巴巴开源内部打磨两年的 AI 代码审查 CLI 工具 Open Code Review(Go 编写,命令名 ocr),正文给出了具体架构细节:多阶段流水线(Grouping/Plan/Main Review/Re-location/Review Filter/Memory Compression)、仅 7 个 Agent 工具、52 份按 glob 映射的规则文档、子 Agent 并发审查与预算控制,并说明自建 AACR-Bench(50 仓库、200 PR、10 语言、1505 个标注问题,数据集公开于 Hugging Face)上 Precision 与 F1 高于通用 Agent、token 约 1/9,但 Recall 刻意偏低。信息密度高、有可验证的工程细节与公开数据集线索,对 Agent 工程化落地有参考价值。局限:评测为项目自建基准,正文未给出具体数值,效果仍需独立验证;X 帖子互动量极低,仅作传播信号,不构成质量背书。
82
正文
[开源分享] Open Code Review
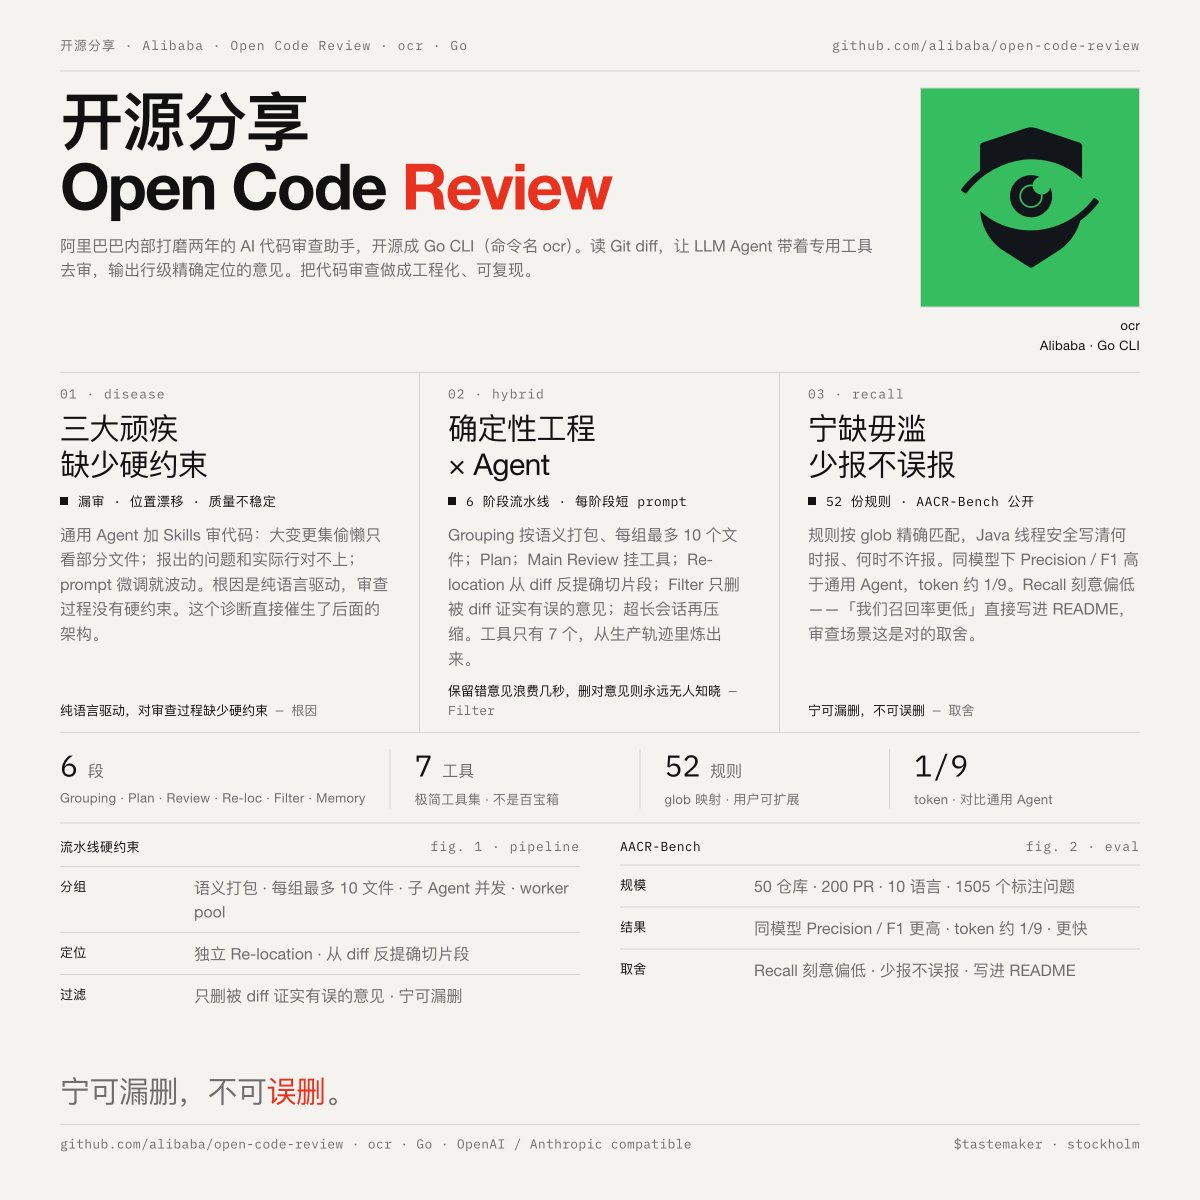
阿里巴巴内部打磨两年的 AI 代码审查助手的开源版本,用 Go 编写的 CLI 工具(命令名 ocr),读取 Git diff,让 LLM Agent 带着专用工具去审查代码,输出行级精确定位的审查意见,把 “代码审查” 做到工程化、可复现。
[github.com/alibaba/open-c…](https://github.com/alibaba/open-code-review)
通用 Agent(如 Codex\Claude Code + Skills)做代码审查的三大顽疾,这也是这个项目架构要解决的:
1. 漏审:大变更集下 Agent 会“偷懒”,只挑部分文件看;
2. 位置漂移:报出的问题和实际代码行对不上;
3. 质量不稳定:纯自然语言驱动,prompt 微调就会引起质量波动。
根因诊断是:纯语言驱动的架构对审查过程缺少硬约束。这个诊断直接催生了它的核心设计。
核心架构:确定性工程 × Agent 混合
多阶段流水线,每个阶段用独立的、短的 prompt 模板(位于 internal/config/template/prompts/):
1. Grouping:先让 LLM 把变更文件按语义聚成审查组(接口与实现、中英文 properties 文件等打包),每组最多 10 个文件
2. Plan:规划风险点与工具调用策略
3. Main Review:Agent 挂载工具进行实际审查,产出意见
4. Re-location:独立的定位模块,从 diff 中反向提取意见对应的确切代码片段——这就是“位置不漂移”的工程保证
5. Review Filter:事实核查模块,只删除被 diff 证实有误的意见。其 prompt 里有一段很精彩的偏置说明:“保留错误意见只浪费审阅者几秒钟,删掉正确意见则永远无人知晓”——宁可漏删,不可误删
6. Memory Compression:超长会话时压缩对话历史,配合 session 恢复机制
Agent 可调用的工具只有 7 个(internal/tool/definitions.go):file\_read、file\_read\_diff、file\_find、code\_search、code\_comment(提交意见)、task\_done,外加 MCP 动态工具扩展。工具集极简,是从大规模生产轨迹中提炼的——每个工具都有明确职责边界,这与通用 Agent 的“百宝箱”思路形成鲜明对比。
文件分组后由子 Agent 并发审查(internal/agent/ 有完整的 worker pool、预算控制、指纹去重、断点恢复实现),既隔离了上下文又控制了 token。
规则体系:注意力的精细分配
内置 52 份规则文档(internal/config/rules/rule\_docs/),通过 system\_rules.json 的 glob 路径映射精确匹配:Java 文件用 java.md,MyBatis mapper XML 用 mapper\_dao\_xml.md,GitHub Workflows、Cargo.toml、protobuf 各有专属规则。
规则本身写得相当克制且实用。以 Java 规则为例:线程安全部分明确列出只在什么情况下报(check-then-act 竞态、非原子复合操作、双重检查锁缺陷)和什么情况下不许报(方法内局部变量、只读操作、已有正确同步)——这正是压低误报率的关键。规则还内嵌了工具调用指引,比如“用 code\_search 确认该方法是否涉及数据库操作”再报循环内查询。用户可通过自定义路径过滤扩展规则。
自建 AACR-Bench 的评测结果
在自建的 AACR-Bench 上评测(50 个热门开源仓库、200 个真实 PR、10 种语言、80+ 资深工程师标注 1505 个问题,数据集公开在 Hugging Face)。
结论:相同底层模型下,Precision 和 F1 显著高于通用 Agent,token 消耗仅约 1/9,速度更快;但 Recall 刻意偏低:宁缺毋滥,少报不误报。
“我们召回率更低”也被直接写进 README 里,这对代码审查场景确实是正确的取舍。
💬0🔄0❤️1👀243📊1