大模型
x.com ·
@meng shao(@shao__meng)
NVIDIA NIM LLM 推理基准指标梳理:TTFT、ITL、TPS 与 RPS 的定义与权衡
该帖围绕 NVIDIA NIM LLMs Benchmarking 2.0.0 的 prefill/decode 两阶段模型,整理延迟类指标(TTFT、端到端请求延迟、ITL/TPOT)与吞吐类指标(系统级与用户级 TPS、RPS)的定义和公式。文中指出 AIPerf 的 ITL 公式为 (e2e_latency − TTFT)/(output_tokens − 1),与部分把 TTFT 计入 ITL 的工具存在口径差异,跨工具比较需注意;并说明并发增加时系统总 TPS 先升后降、单用户 TPS 下降、TTFT 变差的经典权衡,建议容量规划结合业务输入输出长度与目标 TTFT/ITL。
AI推荐理由 内容是对 NVIDIA 官方 NIM LLM Benchmarking 2.0.0 指标文档的系统梳理,给出了 TTFT、e2e latency、ITL/TPOT、TPS、RPS 的定义与公式,并指出 AIPerf 与部分工具在 ITL 是否计入 TTFT 上的分歧,以及并发提升时系统吞吐与单用户体验的权衡。信息密度高、有可核对的官方文档链接,属于对开发者有实际参考价值的技术整理;但本质是二手转述官方文档,未提供独立实测数据,故未给更高分。
78
正文
一起学习 NVIDIA 官方 LLM 推理基准指标定义,把 LLM 推理的每个指标概念都搞清楚!
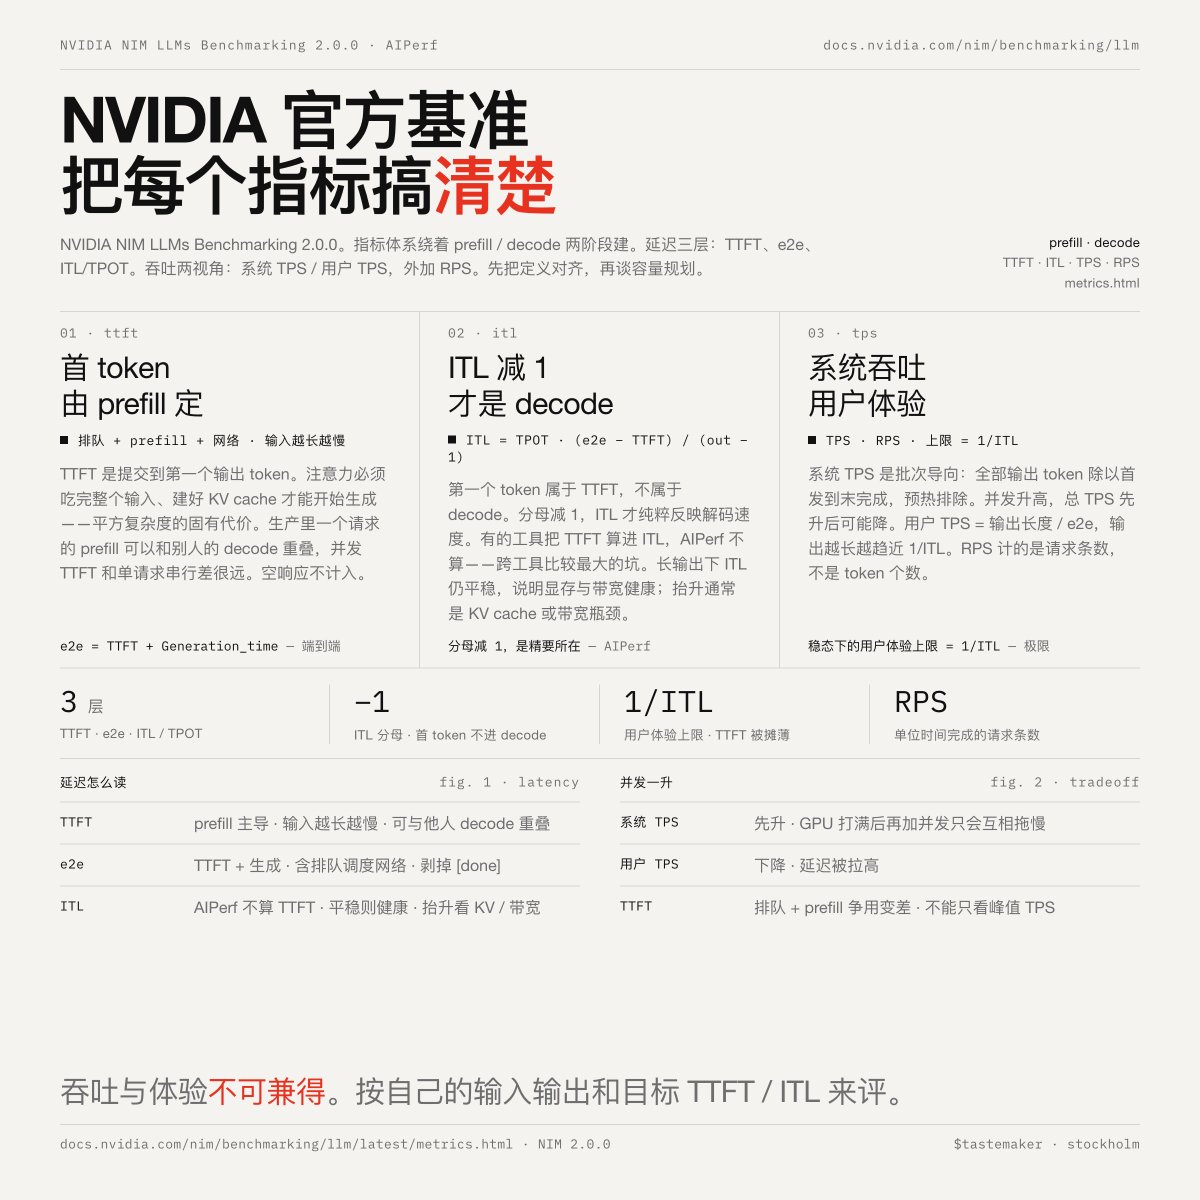
「NVIDIA NIM LLMs Benchmarking 2.0.0」核心是围绕 prefill / decode 两阶段执行模型构建的一套指标体系。
[docs.nvidia.com/nim/benchmarki…](https://docs.nvidia.com/nim/benchmarking/llm/latest/metrics.html)
# 延迟类指标:三个层次
1. TTFT(Time to First Token)— 首 token 延迟
· 定义:从提交请求到收到第一个输出 token 的时间,包含排队时间 + prefill 计算 + 网络延迟。
· 关键洞察:TTFT 主要由 prefill 阶段决定。注意力机制必须处理完整个输入序列、构建好 KV cache,才能开始生成——所以输入越长,TTFT 越长,这是平方复杂度注意力的固有代价。
· 生产环境特点:一个请求的 prefill 可以与其他请求的 decode 阶段重叠执行(continuous batching),因此并发场景下 TTFT 的表现和单请求串行测试差别很大。
· 测量细节:响应为空时 TTFT 无意义,AIPerf 会忽略空的首响应。
2. e2e Request Latency — 端到端请求延迟
· 公式:e2e\_latency = TTFT + Generation\_time,其中 Generation\_time 从收到第一个 token 起算、到收到最后一个 token 为止。
· 包含排队、批处理调度、网络在内的全部时间。AIPerf 会剥掉流式协议末尾的 [done] 信号,避免污染统计。
· 一个易被忽略的成本点:流式模式下 de-tokenization(解码回文本)会随 partial result 反复执行,而 TTFT 也涵盖 tokenization——文本处理开销藏在端到端时间里。
3. ITL / TPOT(Inter-Token Latency / Time Per Output Token)— token 间延迟
· 定义:连续输出 token 之间的平均间隔。ITL 与 TPOT 是同义词。
· AIPerf 公式:ITL = (e2e\_latency − TTFT) / (output\_tokens − 1)
· 分母 减 1 是精要所在:第一个 token 的耗时属于 TTFT(prefill),不属于 decode,减 1 后 ITL 才纯粹反映解码阶段的速度。
· 工具分歧点:有的工具把 TTFT 算进 ITL,AIPerf 不算——跨工具比较时这是最大的坑。
· 判读价值:随着输出变长,KV cache 显存占用增长,注意力计算量随序列长度线性增加。如果 ITL 在长输出下依然平稳,说明系统的显存管理、显存带宽和注意力计算都很健康;ITL 逐渐抬升则通常意味着 KV cache 管理或带宽成为瓶颈。
# 吞吐类指标:系统视角 vs 用户视角
4. TPS(Tokens Per Second)— 出 token 吞吐
· 系统级 TPS:所有并发请求的总输出吞吐。TPS = Total\_output\_tokens / (Ty − Tx),其中 Tx 是第一个请求发出的时刻,Ty 是最后一个响应完成的时刻——这是批次导向的计算,预热阶段(warmup)被排除。
· 重要趋势:并发数增加时系统 TPS 先升后可能降——GPU 算力打满之后,继续加并发只会互相拖慢。
· 用户级 TPS(单客户端视角):output\_length / e2e\_latency,且输出越长越趋近 1/ITL(因为 TTFT 这个“固定成本”被摊薄了)。数学上这给出一个漂亮的极限关系:稳态下的用户体验上限 = 1/ITL。
5. RPS(Requests Per Second)
RPS = total\_completed\_requests / (Ty − Tx),单位时间成功完成的请求数。与 TPS 的区别在于计的是“请求条数”而非“token 个数”。
# 核心权衡(实践指导意义)
并发 ↑ 时
· 系统总 TPS:升高(直至 GPU 饱和后下降)
· 单用户 TPS:下降(延迟被拉高)
· TTFT:因排队和 prefill 争用而变差
这是所有推理服务的经典矛盾:吞吐与体验不可兼得。选型或容量规划时,不能只看厂商宣传的峰值 TPS,必须结合自己业务的典型输入/输出长度和目标 TTFT/ITL 来评估。

meng shao@shao\_\_meng
一个请求进入 LLM 推理引擎后,到底经历了什么?
Together AI 工程师 Zain 讲明白了一个请求的一生:一次传播产一个 token,prefill 吃算力、decode 吃显存,KV 缓存、连续批处理层层接力,Agent 循环再把 GPU 榨干。前缀缓存让 100 轮 Agent 计算量从 55 倍降到 10 倍。 [x.com/i/article/2098…](https://x.com/i/article/2098778068349579264)
[🔗 View Quoted Tweet](https://x.com/shao__meng/status/2098783138118041760)
💬0🔄0❤️1👀389📊1