大模型
x.com ·
@jerryjliu0
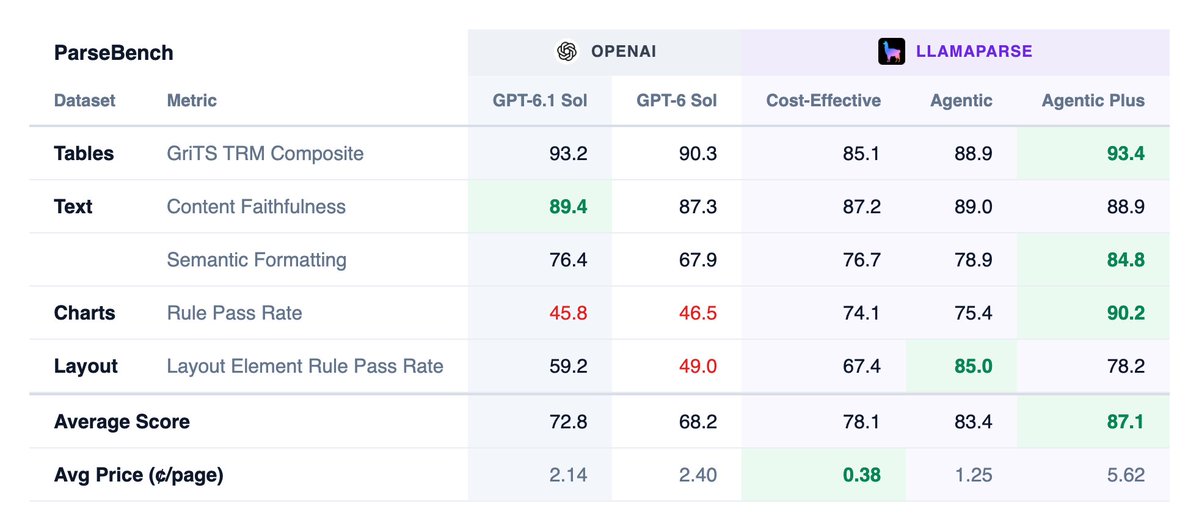
Jerry Liu 对 gpt-6.1 sol 文档 OCR 任务的基准测试观察
LlamaIndex 作者 Jerry Liu 表示,团队对 gpt-6.1 sol 在文档 OCR 任务上做了全面基准测试,相比一周前的 gpt-6 sol,表格解析能力和阅读顺序有明显提升,与 gpt-6 astra 的表格解析水平相近。他指出前沿模型在文档解析上仍比高性价比方案贵约一个数量级,但高端(每页超过 1 美分)能力提升仍有空间,并推荐了 ParseBench 与 LlamaParse。
AI推荐理由 LlamaIndex 作者 Jerry Liu 发布对 gpt-6.1 sol 在文档 OCR 任务上的基准测试结果,称相比一周前的 gpt-6 sol 在表格解析和阅读顺序上有明显提升,并指出前沿模型在文档解析上仍比低成本方案贵一个数量级,同时推广 ParseBench 与 LlamaParse。属于一手评测观察,但未给出具体指标数值,且带有自家产品推广成分。
72
浏览 391
点赞 2
评论 1
转发 0
正文
we comprehensively benchmarked gpt-6.1 sol on document OCR tasks.
compared to gpt-6 sol from a week ago (!), we see a sizable increase in table parsing capabilities and reading order, which is pleasantly surprising. gpt-6.1 sol has similar table parsing as gpt-6 astra.
these are great results. frontier models are still typically an order of magnitude more expensive than cost-effective document parsing solutions, but this also means that there's a lot of alpha in improving capabilities at the "premium" end (>1c per page) of the spectrum too
check out ParseBench: [parsebench.ai](https://www.parsebench.ai/)
for a comprehensive set of document parsing capabilities, check out llamaparse: [cloud.llamaindex.ai](https://cloud.llamaindex.ai/)