大模型
x.com ·
@shao__meng
Qwen-Image-2.1 开源:7B 生成编辑透明三合一图像模型
Qwen 发布开源图像模型 Qwen-Image-2.1,将生成、编辑与原生透明通道统一进 7B 单流 DiT 架构。主要能力包括原生 RGBA 透明图生成与编辑、最多 10 张参考图的高保真编辑(支持圆圈标注、涂画标记与独立 mask)、文字渲染与人像质感提升。架构上采用块因果注意力与 Prefix KV Cache 加速多图推理,VAE 在 latent 空间原生携带透明通道,文本编码器为 Qwen3-VL 8B,默认 40 步推理、原生 2K 分辨率。提供 vLLM 部署选项并适配 8 种芯片平台,权重已在 GitHub、ModelScope 与 Hugging Face 开放。
AI推荐理由 介绍 Qwen-Image-2.1 开源图像模型,含 7B 单流 DiT、块因果注意力、64 通道 RGBA 自编码器、Qwen3-VL 8B 文本编码器等具体架构信息,并附官方博客、GitHub、ModelScope、Hugging Face 链接,信息密度高、可溯源。属官方发布转述,但性能对比表述来自官方宣传,未经独立验证,故未给更高分。
78
浏览 502
点赞 0
评论 2
转发 0
正文
Qwen-Image-2.1 这个只有 7B 参数的生成 + 编辑 + 透明通道三合一开源模型,兼顾平衡性和性价比,图像模型领域可能要进入一个新阶段了。btw... 还有人记得大明湖畔的 🍌 吗 �[qwen.ai/blog?id=qwen-i…](https://qwen.ai/blog?id=qwen-image-2.1)BK
# 四个主要能力
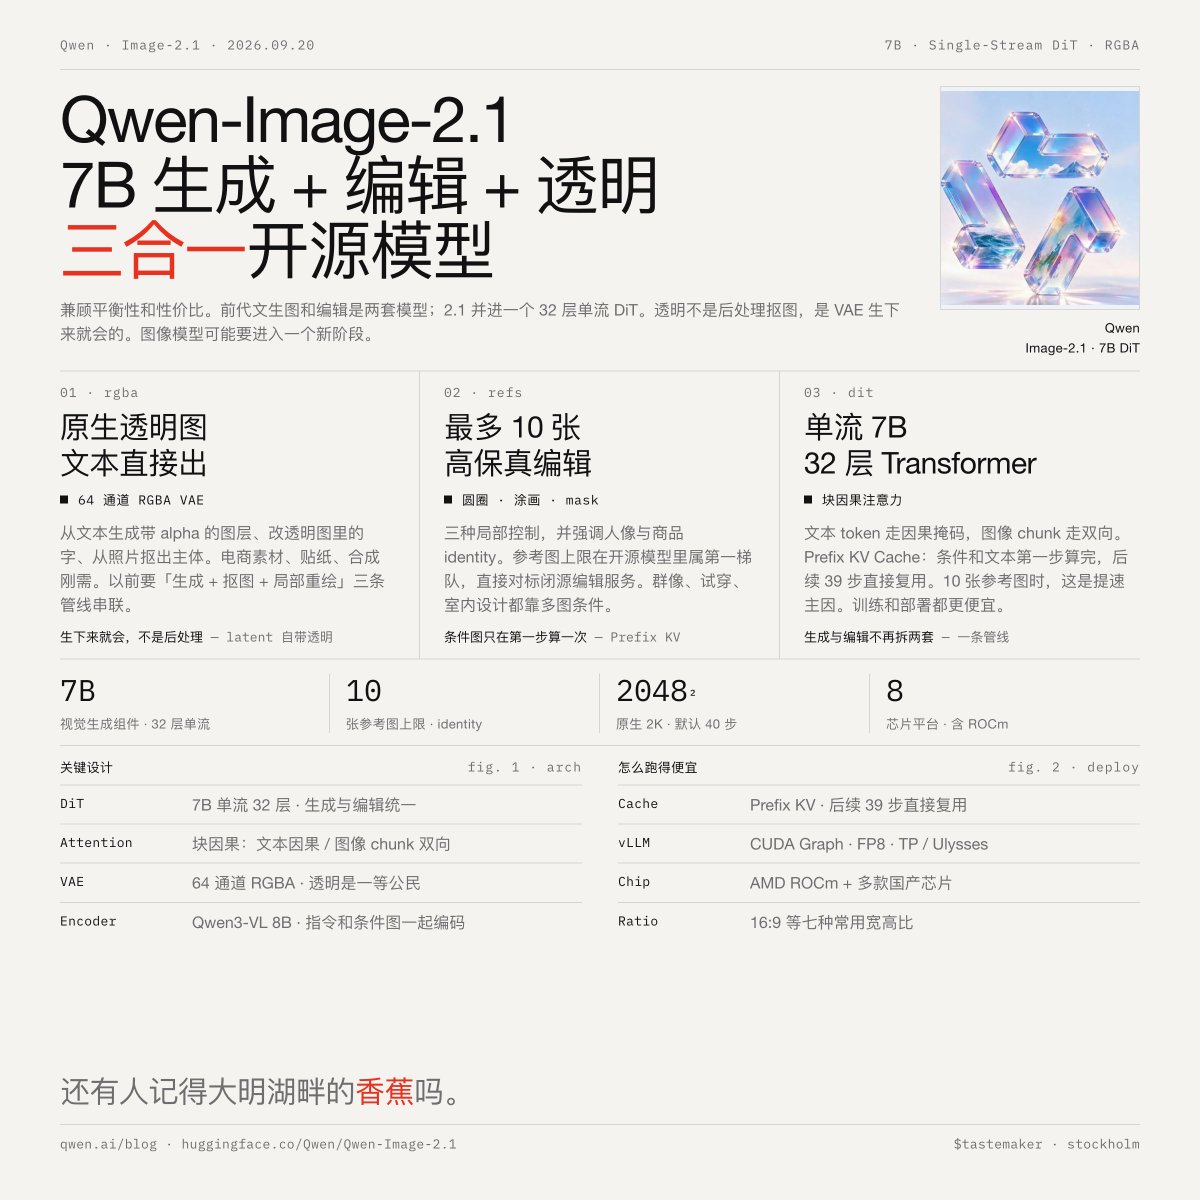
原生透明图生成/编辑:可直接从文本生成带 alpha 通道的 RGBA 图层、编辑透明图内文字、从照片中“抠出”主体。对电商素材、贴纸设计、合成工作流是刚需级功能,此前通常需要“生成模型 + 抠图模型 + 局部重绘”多条管线串联。
最多 10 张参考图的高保真编辑:支持圆圈标注、涂画标记、独立 mask 三种局部控制方式,并强调人像与商品的 identity 保持。参考图数量上限在开源模型中属于第一梯队,直接对标闭源编辑服务(如 GPT-Image 系列的参考图能力)。
质感与排版:文字渲染、人像光影、真实纹理的定性提升;这是 Qwen-Image 系列一贯的传统强项(中文文字渲染尤其如此)。
工程效率:除 KV 缓存外,还提供 CUDA Graph、FP8 量化、TP/Ulysses 并行等 vLLM 部署选项,并适配 8 种芯片平台(含 AMD ROCm 和多款国产芯片),明显在为大规模低成本推理铺路。
# 架构:几处关键设计值得关注
7B 单流 DiT(Single-Stream DiT):相比前代分离式的文生图(Qwen-Image)和编辑(Qwen-Image-Edit)双模型布局,2.1 把生成与编辑统一进一个 32 层的 Transformer,训练和部署成本都更低。
块因果注意力(Block-Causal Attention):文本 token 走因果掩码、图像 chunk 走双向掩码的混合粒度设计。这带来一个实用收益;Prefix KV Cache:条件图和文本只需在第一个去噪步算一次,后续 39 步直接复用缓存。在最多 10 张参考图的多图编辑场景下,这是推理提速的主要来源。
64 通道 RGBA 自编码器:VAE 在 latent 空间原生携带透明通道。透明能力不是后处理抠图,而是模型“生下来就会”的,这是与多数竞品的本质差异。
Qwen3-VL 8B 作为文本编码器:文本指令和条件图由同一个视觉语言模型统一编码,这解释了它在复杂指令跟随和参考图理解上的表现基础。
默认 40 步推理、原生 2K 分辨率(2048²),支持 16:9 等七种常用宽高比。

Qwen@Alibaba\_Qwen
Meet Qwen-Image-2.1, the most balanced and cost-effective image generation model in the Qwen-Image series! Now open weights! 🎨
A unified model for both generation and editing, delivering top-tier quality in a lightweight package.
Highlights: 👀
- Compact & exceptionally fast: A lightweight 7B architecture that outperforms most closed-source models, with drastically accelerated inference for multi-image inputs.
- Native transparency: Natively generates and edits RGBA layers, enabling seamless compositing and text editing within transparent images.
- Versatile, high-fidelity editing: Supports up to 10 reference images and precise local control while preserving strict fidelity for portraits and products.
- Broad coverage & stunning aesthetics: Excels at panoramas, infographics, and virtual try-ons, delivering realistic textures and elegant typography.
Start to create your next masterpiece with Qwen-Image-2.1! 🖼️
- Blo[qwen.ai/blog?id=qwen-i…](https://qwen.ai/blog?id=qwen-image-2.1)7jy
- GitHu[github.com/QwenLM/Qwen-Im…](https://github.com/QwenLM/Qwen-Image-2.1)rWr
- Model Scop[modelscope.cn/models/Qwen/Qw…](https://www.modelscope.cn/models/Qwen/Qwen-Image-2.1)YFR
- Hugging Fac[huggingface.co/Qwen/Qwen-Imag…](https://huggingface.co/Qwen/Qwen-Image-2.1)bVS

[🔗 View Quoted Tweet](https://x.com/Alibaba_Qwen/status/2101659302792679789)