智能体
x.com ·
@shao__meng
CMU 11-768《AI Agents》第 12 讲讲义:强化学习系统
CMU 秋季课程 11-768: AI Agents 由 Graham Neubig 主讲,第 12 讲讲义聚焦 LLM Agent 的 RL 训练系统。内容涵盖推理侧 KV Caching、Prefix Caching、Continuous Batching、Speculative Decoding,训练侧 Activation Checkpointing 与 Prefix Sharing,以及两引擎间的 Weight Sync(PULSE delta 同步)与 MoE 下的 R3 路由重放。还讨论 Agentic RL 常见坑(Sequence Extension、Chat Template 剥离 reasoning、TITO、Sync vs Async)与系统选型(Harness Agnostic 代理、SPMD、Everything-as-a-Service 微服务架构)。
AI推荐理由 CMU 11-768《AI Agents》第 12 讲 RL Systems 讲义公开,正文给出大量具体技术细节与量化数据(KV Cache 每 token 128KB、32k 轨迹约 4GB、ZoRRo 最高 6× 加速、AReaL-DTA 压缩 9.43×、1T 参数全量同步约 2TB 等),并系统梳理训练/推理引擎优化、Weight Sync、R3、TITO、Sync vs Async、SPMD 与微服务架构等工程选型,对 Agentic RL 系统落地有较高参考价值。局限:为第三方对讲义的转述,部分数据来自讲义引用而非独立验证,正文末尾截断。
85
浏览 186
点赞 2
评论 1
转发 0
正文
CMU 秋季最新课程 11-768: AI Agents
第 12 讲讲义公开:Reinforcement Learning Systems
主讲:[@gneubig](https://x.com/gneubig)
课程:[cmu-agents.com](https://cmu-agents.com)
讲义:[cmu-agents.com/slides/lecture…](https://www.cmu-agents.com/slides/lecture-12-rl-systems.pdf)
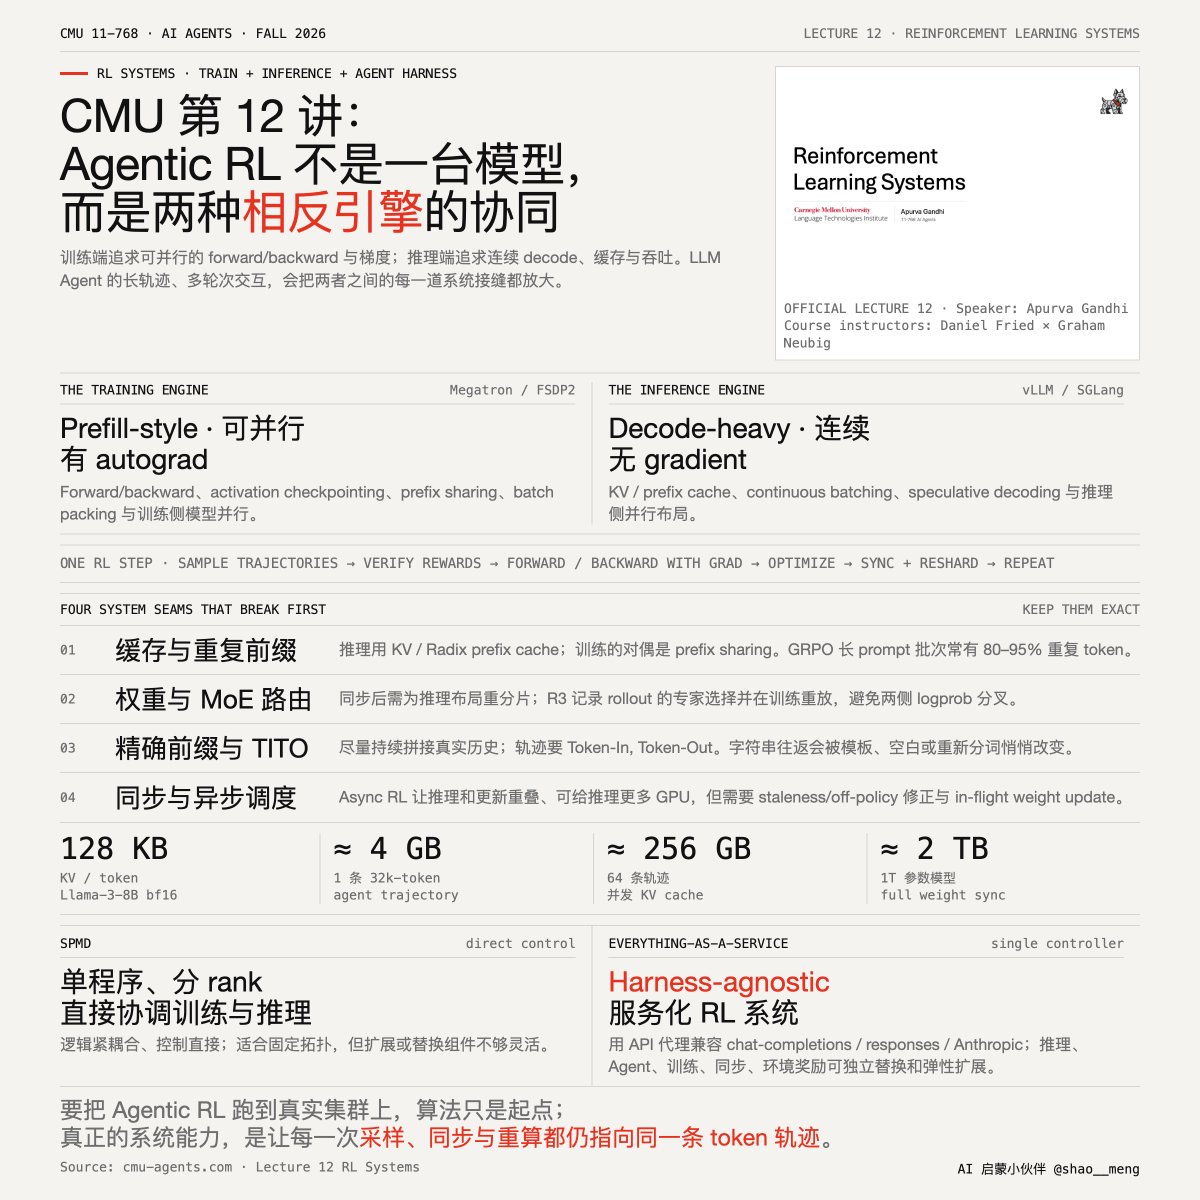
第 12 讲主要针对强化学习系统 (RL Systems),给大家讲明白:要在一个真实的多 GPU 集群上跑通 LLM Agent 的 RL 训练,系统层面到底要解决什么?
[@gneubig](https://x.com/gneubig) 认为:LLM RL 系统的本质,是把两种架构取向完全相反的引擎(训练引擎和推理引擎)强行撮合在一起协同工作,而 Agentic RL 的长轨迹、多轮次特性又把所有矛盾进一步放大。
# 训练和推理两侧引擎各自的优化
推理侧四项技术:
· KV Caching:用内存换重计算。规模感值得记住,Llama-3-8B bf16 下每 token 128KB,一条 32k token 轨迹约 4GB,64 条并发即 256GB。
· Prefix Caching(RadixAttention 等):对 Agentic RL 尤其重要,因为 GRPO 组内多条 rollout 共享同一任务前缀,且同一 rollout 的历史可在后续轮次复用。
· Continuous Batching(Orca 的迭代级调度):以单个 decode step 为粒度调度,完成的序列立即让位给排队请求;通常配合 chunked prefill 或 prefill/decode 分离。
· Speculative Decoding:廉价 drafter 猜 k 个 token、policy 一次并行验证。RL 特有的坑:policy 每步都在变,冻结的 drafter 接受率会衰减,必须用辅助目标(SFT/蒸馏)在线训练 drafter。
训练侧两项:
· Activation Checkpointing:只存每层输入,反向时逐层重算。代价约多一次前向(≈+33% 算力);选择性重算(只针对 attention)代价低得多。
· Prefix Sharing(推理侧 prefix caching 的训练对偶):GRPO 长 prompt 批次中 80–95% 的 token 是重复前缀,用 tree attention mask 只算一次,各分支梯度累加回前缀。Snowflake ZoRRo 报告 actor 更新最高 6× 加速;AReaL-DTA 用前缀树把多轮 τ²-bench rollout 压缩 9.43×,DFS 逐路径训练对比 dense 最高 8.31×。
两引擎之间的“接缝”问题
· Weight Sync:1T 参数模型全量同步约 2TB。但 RL 更新间约 99% 的 bf16 参数不变,只同步 delta(PULSE)即可大幅削减。注意同步后还要按推理引擎的并行布局重新分片。
· R3(Rollout Routing Replay):MoE 模型下,训练与推理引擎的微小数值差异可能选中不同专家,导致两边 logprob 不一致。解法是记录 rollout 时的专家选择,训练时强制重放,这要求推理引擎把路由决策也暴露给训练侧。
# Agentic RL 最容易踩的坑
Sequence Extension。对比两种 harness:A 把每轮追加到完整历史上;B 每两轮把旧交互压缩成摘要 S。从训练批的视角看,A 是单条拼接数据点(action token 上带 loss mask 和广播的 advantage Â),B 则是两条都含 Task 的数据点,重复的 task token 不产生 loss,却要付出上下文计算成本。结论:在可行范围内尽量保持精确前缀、持续拼接(这也是 Tinker 文档的建议)。
Chat Template 的隐患。Qwen3/3.5 默认模板会从历史中剥掉 reasoning 内容,直接破坏 sequence extension。所以 Agent RL 框架(Tinker、PrimeRL)通常自带定制模板/renderers。
TITO(Token-In, Token-Out)。轨迹数据应以 token 而非字符串在引擎间传输。字符串空间的小变换(如模板加了个空白)会导致两边 tokenize 不一致;tokenize 是一一映射,而 detokenize 是多对一,字符串往返是有损的。
Sync vs Async。Sync RL 把训练和推理引擎共置在同一组 GPU 上;Async RL(Pipeline RL、AReaL)拆分 GPU、重叠推理与权重更新,但需要 staleness/off-policy 修正。由于 Agentic RL 往往是 rollout-bound(轨迹长),可以给推理侧更多 GPU(如 3:1),前提是推理框架支持 continuous batching 和 in-flight weight update(SGLang 已支持)。
复杂 harness(子 agent、上下文压缩,RAO/RLM 方向)进一步加大系统复杂度。
# 系统设计选型(从单程序到云原生)
Harness Agnostic 设计。Agent harness 五花八门(Codex、Claude Code、OpenHands、Pi 等),为每个 harness 写定制 rollout 代码是反模式。正确姿势(Agent Lightning 的做法):部署一个模拟推理 API 的中间人/代理服务(兼容 chat-completions、responses、anthropic 等协议),新 harness 接入零代码改动。
SPMD 单程序模式(AReaL <1.0 的做法):一个 Python 程序跑在每个 rank 上,dist. new\_group 划分训练组与推理组,协调逻辑内嵌在程序里。直接可控,但不灵活。
Everything-as-a-Service + 单控制器:轻量编排器(CPU 上的训练循环)+ 推理/Agent/训练/权重同步/环境奖励等独立服务,服务间用标准协议通信(SGLang/vLLM API、Tinker training API、Open Reward Standard)。收益是三重的:关注点分离(研究者可在无重依赖下快速迭代算法)、模块化(同协议即可换实现,托管或自部署皆可)、以及弹性伸缩与异构集群(8×H100 + 4×Mi350 混布,参考 AstraFlow)。
微服务架构还自然衍生出三个高级能力:多策略并行训练(异构多 agent rollout)、部署后在线 RL(Cursor 生产实例:Tab 与 Composer 每 5 小时从真实用户交互产出新 checkpoint)、多租户多 LoRA 训练(8 路并发吞吐优于 8 路串行,需要 Grouped-GEMM/SGMV 特殊内核;Tinker 是这一路线的先驱,其 API 设计很干净,每个训练 run 一个 training client,每个 LoRA checkpoint 一个 sampling client)。

meng shao@shao\_\_meng
周末适合沉下心来系统性的学习基础知识
CMU 秋季最新课程 11-768: AI Agents
主讲:[@dan\_fried](https://x.com/dan_fried)[@gneubig](https://x.com/gneubig)
课程:[cmu-agents.com](https://www.cmu-agents.com/)
视频:[youtube.com/watch?v=Uwfjzy…](https://www.youtube.com/watch?v=UwfjzyLnvMg&list=PLSN0qpDfUvTM)
[🔗 View Quoted Tweet](https://x.com/shao__meng/status/2101274875218608376)