大模型
website ·
微信团队开源多模态 Embedding 模型 WeMM-Embedding
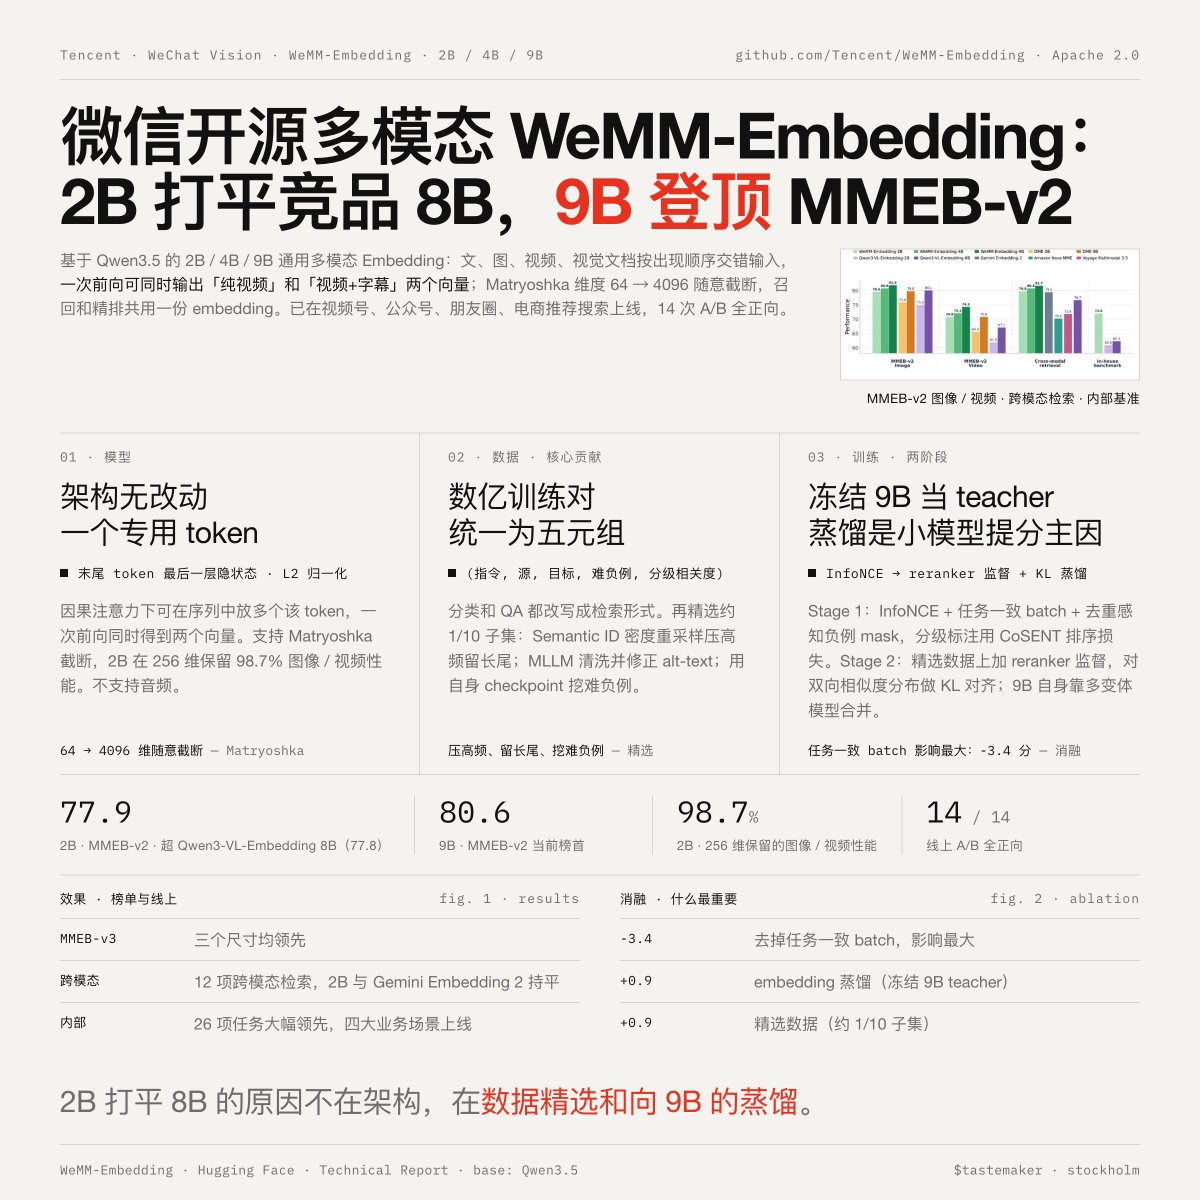
微信开源多模态 Embedding 模型 WeMM-Embedding,基于 Qwen3.5 的 2B/4B/9B 通用多模态 Embedding。2B 在 MMEB-v2 上得分 77.9,超过 Qwen3-VL-Embedding 8B;9B 得分 80.6 为当前榜首。支持文、图、视频、视觉文档交错输入,一次前向可输出纯视频和视频+字幕两个向量。支持 Matryoshka 维度截断,2B 在 256 维保留 98.7% 性能。已在微信多个业务上线,14 次 A/B 测试全正向。
AI推荐理由 该模型在性能上超越更大参数模型,且支持灵活维度截断,对 AI 从业者而言,可降低多模态检索和排序任务的计算成本,提升效率,同时其开源特性便于集成和二次开发。
94
浏览 2,460
点赞 13
评论 9
转发 3
正文
微信开源多模态 WeMM-Embedding:2B 打平竞品 8B,9B 登顶 MMEB-v2
基于 Qwen3.5 的 2B/4B/9B 通用多模态 Embedding,几个关注点:
· 2B 在 MMEB-v2 拿 77.9,超过 Qwen3-VL-Embedding 8B;9B 80.6 当前榜首
· 文、图、视频、视觉文档按出现顺序交错输入,一次前向可同时输出"纯视频"和"视频+字幕"两个向量
· Matryoshka 维度 64→4096 随意截断,2B 在 256 维保留 98.7% 性能,召回和精排共用一份 embedding
· 已在视频号、公众号、朋友圈、电商推荐搜索上线,14 次 A/B 全正向
开源地址:
[github.com/Tencent/WeMM-E…](https://github.com/Tencent/WeMM-Embedding)
模型方面:架构无改动。序列末尾追加一个专用 token,取其最后一层隐状态做 L2 归一化。因果注意力下可在序列中放多个该 token,一次前向同时得到"纯视频"和"视频+字幕"两个向量。支持 Matryoshka 截断(64 → 4096),2B 在 256 维保留 98.7% 图像/视频性能。不支持音频。
数据方面(核心贡献):数亿训练对统一为 (指令, 源, 目标, 难负例, 分级相关度) 五元组,分类和 QA 都改写成检索形式。再从中精选约 1/10 的子集:用 Semantic ID 做密度重采样压高频留长尾,用 MLLM 清洗和修正 alt-text,用自身 checkpoint 挖难负例。
训练方面:两阶段。
Stage 1:InfoNCE + 任务一致 batch + 去重感知负例 mask;有分级标注的数据用 CoSENT 排序损失。
Stage 2:在精选数据上加 reranker 监督(仅部分任务有效)和 embedding 蒸馏——冻结 9B 当 teacher,对双向相似度分布做 KL 对齐,是小模型提分主因。9B 自身靠多变体模型合并。
效果方面:MMEB-v2 上 2B 77.9 超 Qwen3-VL-Embedding 8B(77.8),9B 80.6 为当前榜首;MMEB-v3 三个尺寸均领先;12 项跨模态检索 2B 与 Gemini Embedding 2 持平;内部 26 任务大幅领先,14 次线上 A/B 全正向。消融显示任务一致 batch 影响最大(-3.4 分),蒸馏和精选数据各约 +0.9。

Tencent AI@TencentAI\_News
1B requests a day in Weixin. Now open source.
WeMM-Embedding is built for real traffic and verified in real use. It reads text, image and video in the order they show up.
The 9B ranks #1 on MMEB-v2 (80.6); the 2B keeps 98.7% at just 256 dims.
Truncate to 64 dims for fast recall or 2048 for fine ranking, no retraining.
Try it: [github.com/Tencent/WeMM-E…](http://github.com/Tencent/WeMM-Embedding)
[🔗 View Quoted Tweet](https://x.com/TencentAI_News/status/2095873481917505558)