大模型
x.com ·
@shao__meng
斯坦福 CME 295 第二讲公开:从原始 Transformer 到现代 LLM 的架构演进
斯坦福 2026 秋季课程 CME 295《Transformers & Large Language Models》第二讲讲义公开,共 138 页,围绕模型家族、缩放定律、专家路由、架构优化与解码提示五条主线,梳理从原始 Transformer 到 GPT 类现代大模型的演进。内容包括 Encoder-only 与 Decoder-only 的取舍、Kaplan 与 Chinchilla 缩放定律、MoE 的 top-k 路由与负载均衡、RoPE/SWA/MQA-GQA/RMSNorm 等架构优化,以及贪心、Beam search、top-k/top-p 采样、Guided decoding 和 few-shot、CoT、Self-consistency 等提示范式。
AI推荐理由 内容为斯坦福 CME 295 课程第二讲讲义的详细梳理,涵盖 Transformer 到现代 LLM 的架构演进(Encoder/Decoder-only、Scaling Laws、MoE、RoPE、GQA、解码策略、上下文与提示范式),信息密度高且附有官方讲义链接,对理解 LLM 技术脉络有实际参考价值。局限在于这是第三方对课程内容的转述,并非课程官方发布,且部分表述(如前沿开源模型参数规模)为概括性描述,未提供具体出处;互动量仅作传播信号,不构成质量背书。
72
浏览 853
点赞 11
评论 4
转发 2
正文
斯坦福大学 2026 秋季新课 CME 295: Transformers & Large Language Models 已开课(第二讲公开)
[@stanfordnlp](https://x.com/stanfordnlp) 这门课程由双胞胎兄弟 [@afshinea](https://x.com/afshinea)[@shervinea](https://x.com/shervinea) 主讲,9 讲走完 LLM 全部版图:从 Transformer 架构、注意力变体、RoPE,到 LoRA 微调、RLHF/GRPO 训练,再到 Flash Attention 推理优化、MCP 与 AI Agent、扩散语言模型。
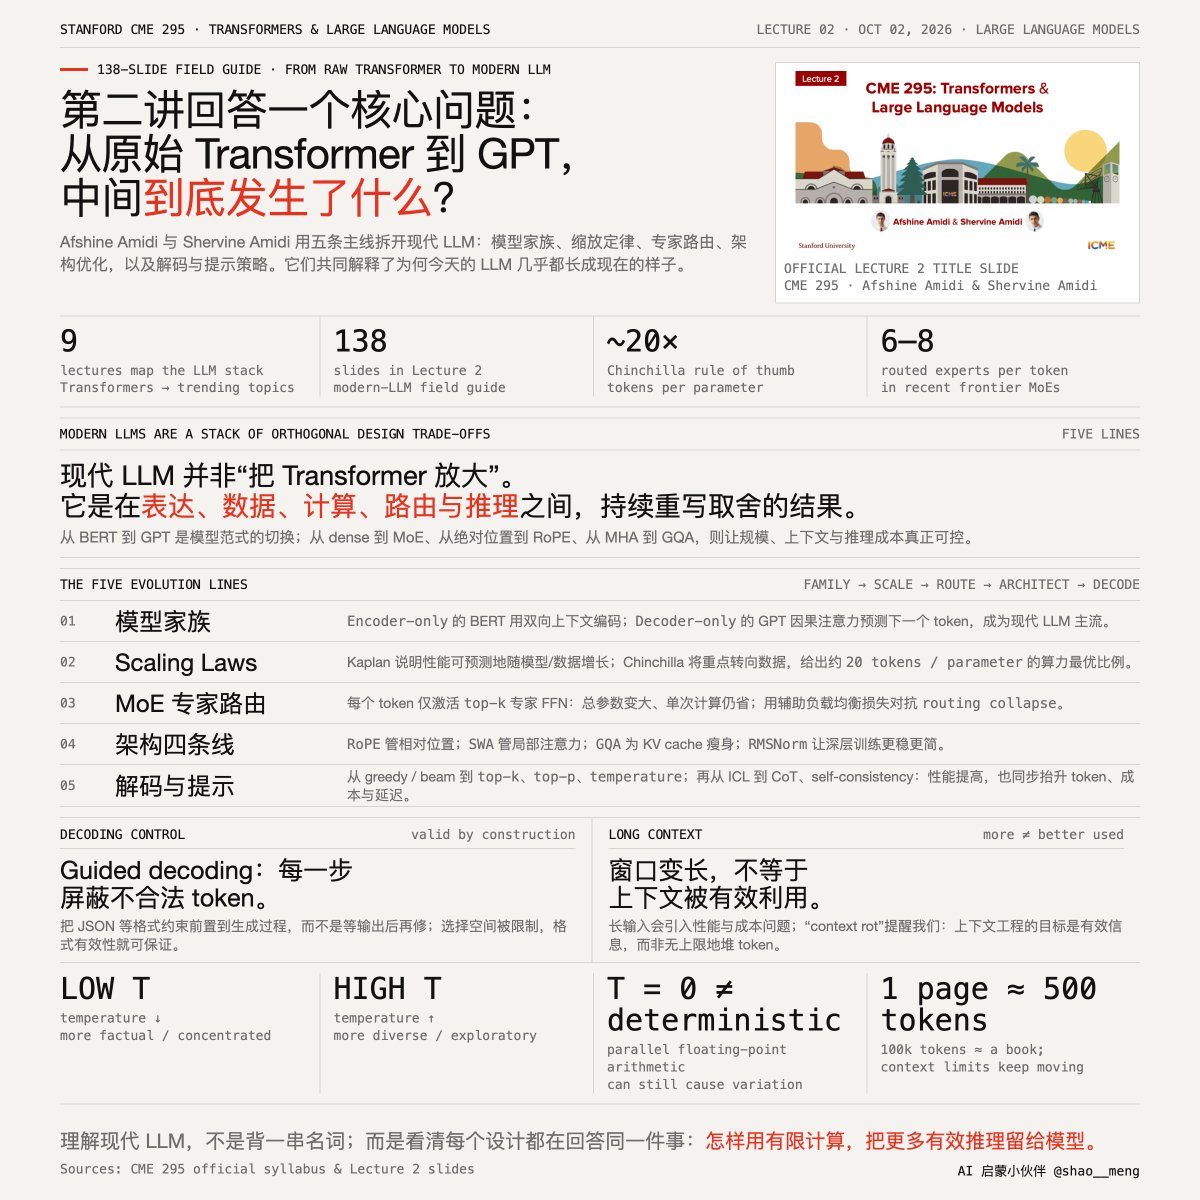
第二讲共 138 页讲义,在第一讲“Transformer 基础”之上,回答一个核心问题:从原始 Transformer 到 GPT 这类现代大模型,中间发生了什么。全讲按五条主线展开:模型家族 → 缩放定律 → 专家路由 → 架构优化 → 解码与提示词策略。
讲义在这:[cme295.stanford.edu/slides/fall26-…](https://cme295.stanford.edu/slides/fall26-cme295-lecture2.pdf)
模型家族:对 Transformer 做减法
Encoder-only(BERT):双向注意力编码语义,靠 MLM + NSP 预训练,必须微调才能用,不适合生成。
Decoder-only(GPT):因果注意力自回归生成下一个 token。现代 LLM 几乎全是这一形态(GPT、DeepSeek、Qwen、GLM、Kimi…)。
Scaling Laws:为什么要大
Kaplan 2020:更大模型 + 更多数据 → 性能可预测提升,且大模型更省样本。
Chinchilla 2022:固定算力下最优比例约为 20 token / 参数——从堆参数转向堆数据。
LLM 定义:给 token 序列分配概率,量级为参数 10B+、数据数千亿 token、大量 GPU。
MoE:参数大、计算省
用多个专家 FFN 替换单个 FFN,门控逐 token 只激活 top-k 个专家。
难点是 routing collapse(总选同一专家),用辅助负载均衡损失解决。
趋势:共享专家 + 细粒度专家。现状:前沿开源模型总参数 0.5T–1T、专家数百个,但每 token 只激活约 6–8 个。
架构优化:四条正交演进线
位置:编码绝对 → 相对 → RoPE,重点是 RoPE 旋转 q/k,内积只依赖相对距离,是当前默认
注意力:稠密 → SWA,重点是滑动窗口只看近邻,类 CNN 感受野,多层堆叠扩大范围
KV 头:MHA → MQA → GQA,重点是组内共享 K/V,给 KV cache 瘦身,当今主流
归一化:Post-Norm+LayerNorm → Pre-Norm+RMSNorm,重点是深网络训练更稳、计算更简,现代标配
解码策略
贪心:取最高概率,局部最优 ≠ 全局最优;Beam search:保留 k 条路径,贵且仍缺创造力。
采样:top-k(前 k 个)或 top-p(累计概率达 p 的自适应集合);温度 T 调节分布尖平,低 T 事实性、高 T 多样性。
即便 T=0 也难完全确定(浮点并行的非结合性)。
Guided decoding:每步屏蔽不合法 token,保证 JSON 等格式有效。
上下文与提示
量级:上下文 O(1M)、输出 O(100k) 且边界正在消失。换算:1 页 ≈ 500 token,10 万 token ≈ 一本书。
Context rot:窗口更长 ≠ 用得更好,长输入会拖累性能。
提示三范式,性能与成本同升:few-shot ICL(给示范)→ Chain-of-Thought(先推理后作答)→ Self-consistency(多路径推理投票)。

meng shao@shao\_\_meng
斯坦福 [@stanfordnlp](https://x.com/stanfordnlp) 新课 CME 295,双胞胎兄弟 [@afshinea](https://x.com/afshinea)[@shervinea](https://x.com/shervinea) 主讲,9 讲走完 LLM 全部版图:从 Transformer 架构、注意力变体、RoPE,到 LoRA 微调、RLHF/GRPO 训练,再到 Flash Attention 推理优化、MCP 与 AI Agent、扩散语言模型。
课程和知名速查表全部公开。 [x.com/i/article/2100…](https://x.com/i/article/2100019396664336384)
[🔗 View Quoted Tweet](https://x.com/shao__meng/status/2100023307487809721)