AI编码
x.com ·
@shao__meng
开源项目按公司整理35家AI公司的AI工程师面试题
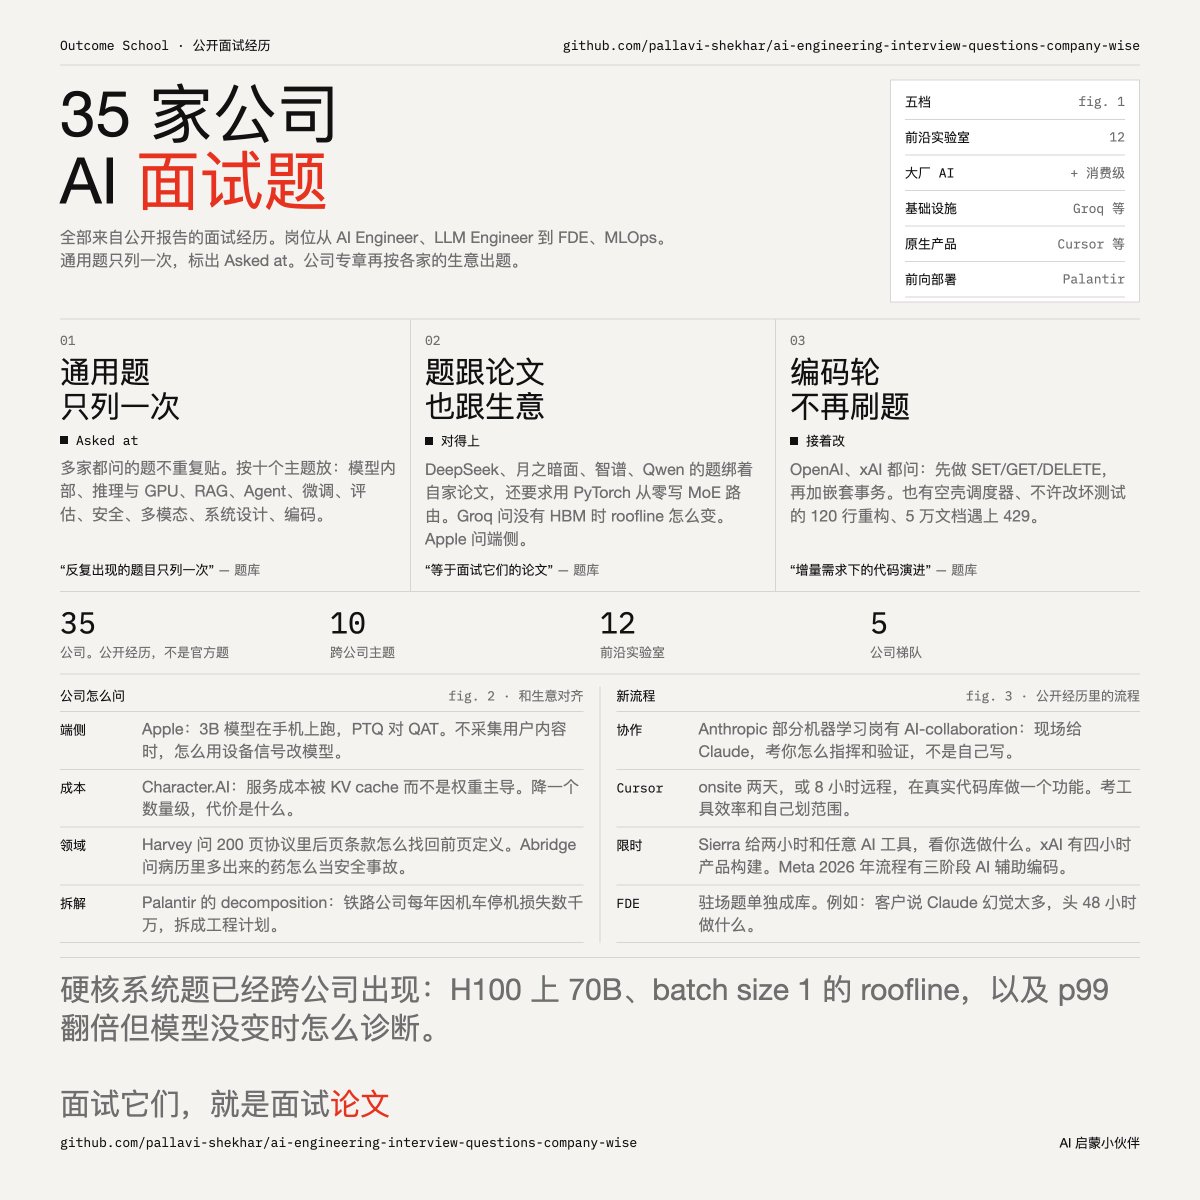
有团队开源了一份AI工程师面试题合集,覆盖OpenAI、Anthropic、DeepMind、xAI、DeepSeek、Kimi、GLM等AI实验室,Cursor、Cognition、ElevenLabs等AI原生公司,以及Nvidia、Microsoft、Amazon、Apple等大厂。内容分两层:跨公司通用题按LLM机制、推理与GPU性能、RAG、Agent与工具调用、微调对齐、评估可观测性、安全、多模态语音、系统设计、编码题十大主题组织;第二层为35家公司专属章节。帖子还指出各公司考察方向与商业模式高度相关,例如DeepSeek系绑定自家论文、Groq聚焦SRAM架构roofline、Apple侧重端侧模型、Harvey与Abridge考察领域约束工程。
AI推荐理由 该帖介绍一个开源项目,按公司维度整理了35家AI公司的AI工程师面试题,声称题目来自公开报告的面试经历,并给出GitHub地址。正文详细列出双层结构(跨公司通用题+公司专属章节)和十大主题,涵盖LLM机制、推理服务、RAG、Agent、微调对齐、评估、安全、多模态、系统设计与编码题,还归纳了DeepSeek、Groq、Apple、Character.AI、Harvey、Palantir等公司的差异化考察方向。对AI工程师求职者和团队招聘有实际参考价值,信息密度高。局限:题目来源为二手整理,未逐条核验,且面试题时效性会随公司变化;互动量低不代表内容质量。
72
浏览 131
点赞 0
评论 1
转发 1
正文
这个开源项目系统整理了 35 家 AI 公司的 AI 工程师面试题,全部来自 “公开报告的面试经历”
来自 [@outcome\_school](https://x.com/outcome_school) 团队 [@pallavishekhar\_](https://x.com/pallavishekhar_) 开源发布,内容几乎涵盖了 OpenAI、Anthropic、DeepMind、xAI、DeepSeek、Kimi、GLM 等 AI Labs,Cursor、Cognition、ElevenLabs 等 AI Native 团队和 Nvidia、Microsoft、Amazon、Apple 等头部大厂。
覆盖的岗位头衔也非常多:AI Engineer、LLM Engineer、Gen AI Engineer、ML Engineer、Research Engineer、Applied Scientist、FDE、MLOps/LLMOps 工程师等。
开源地址:[github.com/pallavi-shekha…](https://github.com/pallavi-shekhar/ai-engineering-interview-questions-company-wise)
# 内容架构:一个精心设计的双层结构
第一层:跨公司通用题(Common Questions)。
作者把在多家公司反复出现的题目只列一次,标注"Asked at"哪些公司,按十大主题组织:
1. LLM 内部机制与架构 — attention 缩放因子、KV cache 内存公式推导、MQA/GQA/MLA、FlashAttention、BPE、RoPE/YaRN、Chinchilla scaling laws、MoE、解码采样策略、lost-in-the-middle、RMSNorm、SwiGLU
2. 推理、服务与 GPU 性能 — prefill vs decode、continuous batching、PagedAttention、投机解码、量化(FP16→FP4)、五种并行策略、TTFT/TPOT 指标、H100 上的 roofline 计算、vLLM/SGLang/TensorRT-LLM 选型、“如何把服务成本降 10 倍”
3. RAG 与检索 — 分块策略、BM25 vs 稠密检索、重排序器、HyDE、权限感知检索、ANN 索引、索引新鲜度、答案归因
4. Agent 与工具调用 — ReAct、MCP、工具 schema 设计、多智能体编排、Agent 记忆、循环终止条件、人类审批
5. 微调与对齐 — RLHF/DPO/GRPO/RLVR 全谱系、LoRA/QLoRA 数学、灾难性遗忘、“提示 vs RAG vs 微调”决策框架、蒸馏、reward hacking
6. 评估与可观测性 — LLM-as-judge 及其偏差、幻觉检测、基准污染、Agent 评估、回归门禁
7. 安全与负责任 AI — 提示注入(直接/间接)、OWASP LLM Top 10、护栏、Constitutional AI、红队
8. 多模态与语音 — VLM、语音 Agent 延迟预算、barge-in 打断处理、级联 vs 端到端语音、ASR/TTS 评估
9. AI 系统设计 — 十类高频设计题(千万级文档企业 RAG、代码助手、客服 Agent、Text-to-SQL、LLM 网关、数亿用户聊天服务等)
10. 编码题 — 从零实现 attention、KV cache、BPE、采样;LRU 缓存、令牌桶限流器、异步批处理器、SSE 流解析器、最小 Agent 循环
第二层:35 家公司的专属章节,分为五大梯队:
1. 前沿实验室(12 家):Anthropic、OpenAI、Google DeepMind、Meta、xAI、Mistral、Cohere、DeepSeek、月之暗面(Kimi)、智谱(GLM)、阿里(Qwen)、Sarvam AI(印度)
2. 大厂 AI 组织:Microsoft、Amazon、Apple、NVIDIA、Tesla,以及一组消费级 ML 公司(Uber/Netflix/LinkedIn/Airbnb/Pinterest/Spotify)
3. AI 基础设施公司:Databricks、Groq、Together AI、Hugging Face、Scale AI、Perplexity
4. AI 原生产品公司:Cursor、Cognition(Devin)、Sierra、Harvey(法律)、Glean、[Character.AI](http://Character.AI)、ElevenLabs、Abridge(医疗)、Figure AI(机器人)、Waymo
5. 前向部署/企业 AI:Palantir
# 题目分布透露的行业信号同样值得关注
1. 公司的差异化考察方向,和它的商业模式严丝合缝。 这是最能体现整理功力的地方:
· DeepSeek、月之暗面、智谱、Qwen 的题目深度绑定自家论文——MLA、auxiliary-loss-free 负载均衡、Multi-Token Prediction、MuonClip、DualPipe、长上下文扩展、GLM 的 thinking 模式。面试这些公司等于面试它们的论文,还要求 PyTorch 从零实现 MoE 路由。
· Groq 的题全是 SRAM-only 架构下的 roofline 重推演:“没有 HBM,decode 的 roofline 论证哪里变了”、“确定性在 p99 层面到底买到什么”。
· Apple 清一色端侧:3B 模型在手机上跑、PTQ vs QAT、不采集用户内容的前提下用设备信号改进模型、30+ 语言区无法记录用户内容的评估方案。
· CharacterAI 是推理经济学:“我们的服务成本被 KV cache 而非权重主导,降一个数量级,代价是什么”。
· Harvey(法律)和 Abridge(医疗) 考的是领域约束下的工程:200 页信贷协议里第 140 页的条款依赖第 8 页的定义术语怎么检索、生成的病历中出现了患者没提过的药怎么当作安全事故处理、PHI 如何约束整个架构。
· Palantir 的招牌是 "decomposition" 轮:把“一家货运铁路公司每年因机车非计划停机损失数千万”分解成工程计划。
2. 编码轮的形态正在发生实质性变化。 文档里反复出现的一类题,与传统 LeetCode 明显不同:
· “实现一个内存 KV 存储:先 SET/GET/DELETE,再加事务 BEGIN/COMMIT/ROLLBACK,包括嵌套事务”(OpenAI、xAI 都问)
· “给你一个 LLM 推理引擎的调度器类,其中一个方法是空壳,没有规格没有文档。说说你头三十分钟干什么”(xAI)
“重构这 120 行能跑但很乱的代码,不许破坏测试”(OpenAI)
· “对 5 万个文档跑 LLM 调用,API 限 100 并发、偶发 429 和超时,把 Python 写出来”(Anthropic)
考察重心从算法记忆转向增量需求下的代码演进能力、并发正确性、真实工程约束下的取舍。
3. “AI 协作轮”作为新题型已经进入正式面试流程。 这是文档里最前沿的信号:
· Anthropic 部分机器学习岗有 AI-collaboration 轮:现场给你 Claude,考察的是你如何指挥它和验证它的产出,而不是你自己写。
· Meta 2026 年的流程新增三阶段 AI 辅助编码轮(探索修复 → 实现新功能 → 扩展改进)。
· Cursor 的 onsite 是两天在真实 Cursor 代码库上做一个功能(或 8 小时远程版),明确考核你对 AI 工具的使用效率和自主 scoping 能力。
· Sierra 给你两小时和任意 AI 工具,看你选择做什么。
xAI 有四小时限时产品构建。
4. FDE 成为一级岗位类别。 Anthropic、OpenAI、Databricks、Scale、Together、Sierra、Harvey、ElevenLabs、Palantir 的章节里都有 "Applied and Forward-Deployed Scenarios" 专属题库——典型题目如“企业客户说 Claude 幻觉太多,你是驻场工程师,头 48 小时做什么”。这对应了 AI 公司向企业交付方式的转变:模型能力差距收窄后,落地能力成为差异化。
5. 硬核系统题的普及。 "H100 上 70B 模型 batch size 1 的 roofline 计算"、"估算 70B 模型的 GPU 显存(权重 + KV cache + 激活 + 碎片)"、"p99 延迟在部署后翻倍但模型没变,走一遍诊断”——这类题横跨 NVIDIA、Together、OpenAI、Perplexity 等多家,说明推理性能的量化直觉已成为 AI 工程师的通用素养,而非基础设施工程师的专属。