智能体
x.com ·
@shao__meng
语音 Agent 的瓶颈不在 STT:Krisp 语音隔离基准显示竞争说话人干扰是上游问题
Sumanth_077 与 Krisp 合作发布 Voice Isolation 基准,覆盖办公、呼叫中心、电话通话三种场景,265 条真实录音、47 位说话人,测试 11 种 STT 配置。结果显示原始音频整体 WER 23.3%,隔离后降至 6.2%;办公场景 31.8%→6.3%,呼叫中心 23.9%→6.9%,电话通话因几乎无竞争语音反而从 3.5% 轻微升至 3.9%。作者据此提出语音 Agent 存在两个独立问题:转对词语(STT 准确率)与转对说话人(归属正确性),并建议将语音隔离作为独立环节插入流水线:麦克风→语音隔离→STT→回合检测→Agent→工具→响应。
AI推荐理由 转述 Sumanth_077 与 Krisp 合作的 Voice Isolation 基准:265 条真实录音、47 位说话人、三种场景、11 种 STT 配置,给出原始音频与隔离后 WER 对比(整体 23.3%→6.2%,Phone Calls 3.5%→3.9% 轻微劣化),并提出“转对词语 vs 转对说话人”的区分及把语音隔离作为独立流水线环节的落地建议。信息密度高、有具体方法与数据,对语音 Agent 开发者有实际参考价值;但为二手转述,未提供基准原始链接与可复核细节,数据需以原报告为准。
82
浏览 178
点赞 0
评论 0
转发 0
正文
STT 已经足够强,为什么你的语音 Agent 还在出错?
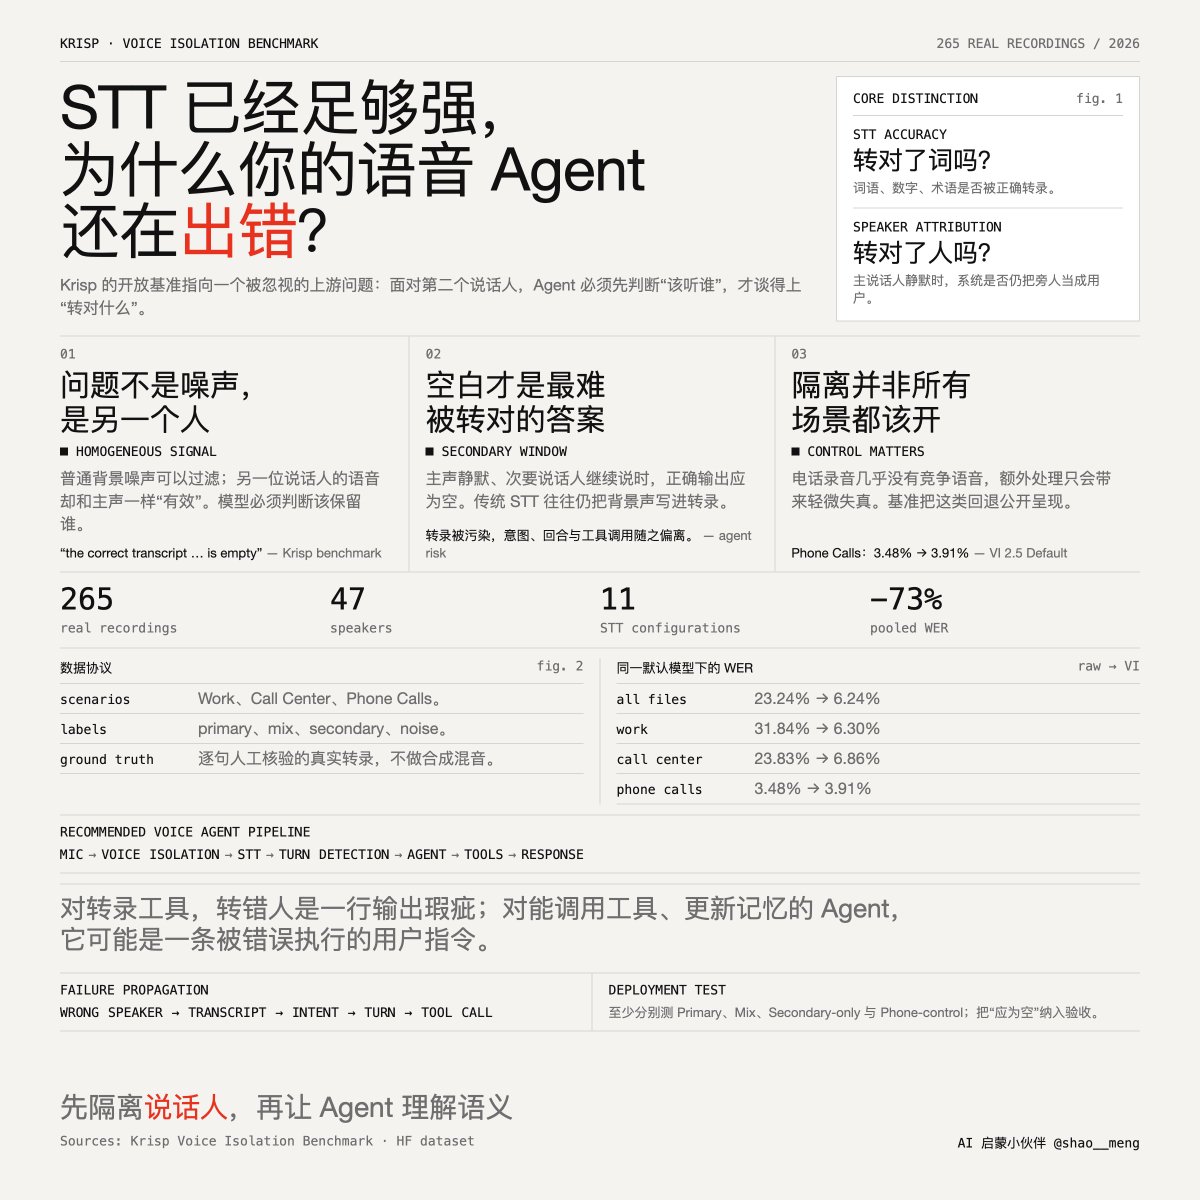
[@Sumanth\_077](https://x.com/Sumanth_077) 发布了一个与 Krisp 合作构建的 Voice Isolation 基准测试,核心发现是:语音 Agent 的瓶颈已经不在 STT 本身的准确率,而在竞争说话人干扰这个上游问题。
推理链条是这样的:现代 STT 模型已经能很好地过滤普通背景噪声,但"背景里另一个人的说话声"在信号层面与主说话人完全同质;模型收到的是两路同样有效的语音信号,必须做"听谁"的判断。干扰由此进入下游:污染转录文本、扭曲意图识别、误触发对话回合,甚至驱动 Agent 执行错误操作。
基准的核心发现
数据与方法:265 条真实录音、47 位说话人,覆盖办公(Work)、呼叫中心(Call Center)、电话通话(Phone Calls)三种场景,人工标注了主说话人/混叠/次要说话人/噪声段落,并有逐句人工核对的参考转录。测试横跨 11 种 STT 配置(Deepgram、AssemblyAI、Google、ElevenLabs、Soniox、Nvidia、Cartesica 等)。
主要结果(原始音频 WER vs 隔离后 WER):
整体:23.3% -> 6.2%
Work:31.8% -> 6.3%
Call Center:23.9% -> 6.9%
Phone Calls:3.5% -> 3.9%
最有说服力的两点设计:
· 跨模型横向覆盖。每个 STT 系统都是"自己对自己"对比(原始音频 vs. 隔离后音频),证明问题出在模型上游的信号层面,而非某家 STT 的能力短板。
· Phone Calls 场景的轻微劣化。电话录音几乎不存在竞争语音,隔离处理反而带来轻微失真导致 3.5%→3.9%。
核心洞察:两个不同的问题
提出了一个值得记住的区分,语音 Agent 面对的实际是两个独立的问题:
· 转对了词语吗(STT 准确率),这是业界一直优化的;
· 转对了说话人吗(归属正确性),这是被普遍忽视的。
对一个只会生成文本的转录工具来说,转错人只是输出瑕疵;但对一个能调用工具、更新记忆、执行操作的语音 Agent 来说,把隔壁同事的话当成用户指令,是级别严重得多的失败。这个区分是全文最有价值的部分。
落地建议是把语音隔离作为独立环节插入流水线:麦克风 → 语音隔离 → STT → 回合检测 → Agent → 工具 → 响应。

Sumanth@Sumanth\_077
[x.com/i/article/2105…](https://x.com/i/article/2105662393665892353)
[🔗 View Quoted Tweet](https://x.com/Sumanth_077/status/2105666969483743666)