算力商业
x.com ·
@meng shao(@shao__meng)
Jev 产品解读:结构化输出与校准置信度如何回应 RLHF 幻觉问题
该帖回顾 TypeSafe AI CEO 在 AI Engineer 的演讲「Why RLCD beats RLHF」,并将其与 Jev 的产品设计逐条对应。作者认为 Jev 的关键差异是不生成自由文本,输出结构与取值预先定义,并附带校准概率,使开发者可按置信阈值决定自主执行或转人工;同时将 Jev 定位为'智能 if 语句',面向分类、路由、评分、抽取等场景,并称其输出 token 免费、公司自称已盈利。文中'快两个数量级、便宜两个数量级'等性能与商业数据均为产品方宣称,未提供独立验证。
AI推荐理由 这是一条对 TypeSafe AI 产品 Jev 的二手解读帖,核心信息来自作者对一场演讲的转述与产品官网/博客的对照,属于观点性长文而非官方发布。其具体新信息在于:Jev 采用结构化输出而非自由文本生成,声称类型错误在数学上不可能发生,并附带校准置信度,让开发者设阈值决定自主执行或上报人工;作者还将其与 RLHF 导致的过度自信、Claude Code 的辅助定位、以及 Jevons 悖论命名做了关联。局限也很明显:文中'快两个数量级、便宜两个数量级''已盈利'等说法均来自产品方宣称,无独立验证;'发布三天刷屏'属传播描述,不能作为质量证据;演讲与产品规格的对应关系是作者推断,非官方确认。
62
正文
Jev [@typesafeai](https://x.com/typesafeai) 发布三天、刷屏 X 信息流!
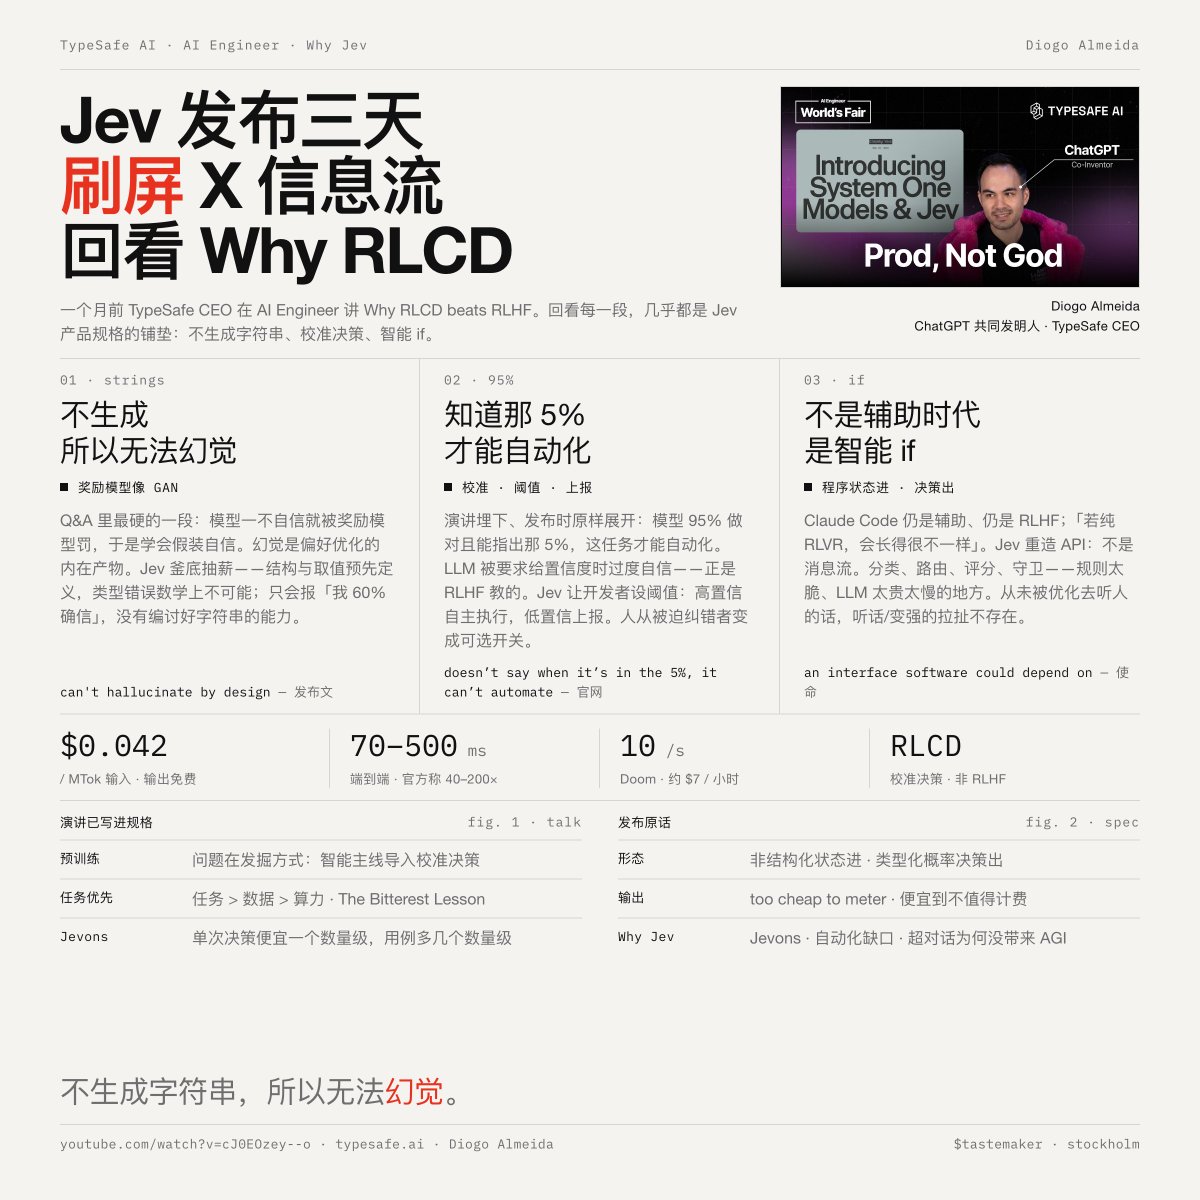
再回看一个月前 TypeSafe AI CEO [@CompleteSkeptic](https://x.com/CompleteSkeptic) 在 [@aiDotEngineer](https://x.com/aiDotEngineer) 主题演讲「Jev Creator: Why RLCD beats RLHF」,每一段论证几乎都是 Jev 产品规格的铺垫!
Youtube:[youtu.be/cJ0EOzey--o](https://youtu.be/cJ0EOzey--o)
# “取悦人类是幻觉的根源” → “不生成字符串,所以无法幻觉”
演讲中技术含量最高的部分是 Q&A 里那段:奖励模型存在类似 GAN 的不对称性,模型的不自信很容易被奖励模型识别并惩罚,于是模型学会丢弃不确定的模式、假装自信,幻觉是偏好优化的内在产物。
Jev 的回应是釜底抽薪:根本不生成自由文本。输出结构和取值预先定义,类型错误在数学上不可能发生;每个输出附带“认识论上诚实”的概率。演讲里那个 “放屁音效被夸成氛围音乐” 的段子,对应的正是 LLM 在不知道时必须编一个讨好你的字符串;Jev 没有编字符串的能力,只有说“我 60% 确信”的能力。
# “校准的决策能力” → Jev 的核心卖点
演讲埋了最重要的一句产品逻辑,Jev 发布时原样展开:“如果一个模型 95% 的时候做对,且它能告诉你自己何时处于那 5%,这个任务就可以被自动化。” 现有 LLM 被要求给置信度时过度自信且不一致(这正是 RLHF 教出来的),而 Jev 让开发者设阈值,高置信自主执行、低置信上报人工。这就是“人在 loop 中”从被迫的纠错者变成可选的开关。
# “不是 Claude Code 时代” → 产品定位的直接对立
演讲说 Claude Code 仍是辅助时代、仍是 RLHF,"if it was purely RLVR, it would look very different"。Jev 走得更远:连 API 形态都重造,不再是消息流,是结构化程序状态进、类型化决策出。演讲里指出的“agent 能力变强就不听话、听话就变弱”的优化空间拉扯,在 Jev 的框架里不存在,因为它从未被优化去听人类的话。
# “SaaS 自 2019 年没变过” → Jev 的目标市场
演讲中对软件的“哲学牢骚”(我们只自动化了写软件,软件本身没变聪明)正是 Jev 的产品定位:“智能 if 语句”。分类、路由、评分、抽取、分支、守卫,那些手写规则太脆、上 LLM 又太贵太慢太不可靠的地方。Doom demo(每秒 10 次查询、约 $7/小时)和 Wikiracing 展示的正是“软件直接依赖 AI”的形态。官网使命一句话:“AI needs an interface software could depend on”,这就是演讲里“smarter software, not just-in-time software”的工程化表述。
# “预训练不是问题” → Jev 的智能来源策略
演讲明确说:把互联网压缩成智能内核是了不起的,问题在于“发掘方式”。Jev 的实现路径与此一致——不重造智能,而是把预训练模型的智能 “主线导入” 到校准决策中,所以它敢宣称在 System One 任务上与前沿 LLM 智能相当,同时快两个数量级、便宜两个数量级。
# “任务 > 数据 > 算力” → 定价的商业逻辑
演讲中对 Sutton 苦涩教训的修正(“在游戏中算法比算力重要,现实中不成立;任务的选择比数据和算力都重要”)对应官网第二篇博客「The Bitterest Lesson」。这也解释了 Jev 反常的定价:输出 token 免费(“便宜到不值得计费”)、公司自称已盈利且要继续降价。他们赌的不是单位智能的价格战,而换了一个任务空间,在这个空间里同样的智能可以近乎免费地复用。
# 名字本身:Jevons 悖论
"Jev" 纪念 William Stanley Jevons,蒸汽机效率提高反而增加了煤的总消耗。这是对产品经济学的自我注解:智能的单次决策成本每下降一个数量级,消耗智能的用例会增加更多个数量级。演讲里“这些工作简单到可以反复近乎零成本执行”的描述,正是这个逻辑。回看标题 "Why Jev",一语三关:为什么叫 Jev(Jevons)、为什么需要 Jev(自动化缺口)、以及发布推文里那句自我追问:为什么共同发明了 ChatGPT 的超级对话模型却没有带来 AGI。

AI Engineer 🔜 Paris 🇫🇷@aiDotEngineer
Why [@CompleteSkeptic](https://x.com/CompleteSkeptic) created ChatGPT and then spent 2 years in stealth building Jev
[Your browser does not support the video tag.](https://video.twimg.com/amplify_video/2101096263353856000/vid/avc1/1920x1080/QXR6IbV2upNr7v69.mp4?tag=29)
[🔗 View on Twitter](https://x.com/aiDotEngineer/status/2101096346249830495/video/1)
[🔗 View Quoted Tweet](https://x.com/aiDotEngineer/status/2101096346249830495)
💬0🔄0❤️0👀233