大模型
x.com ·
Perplexity 开源为 Apple Silicon 优化的本地推理引擎 Lily
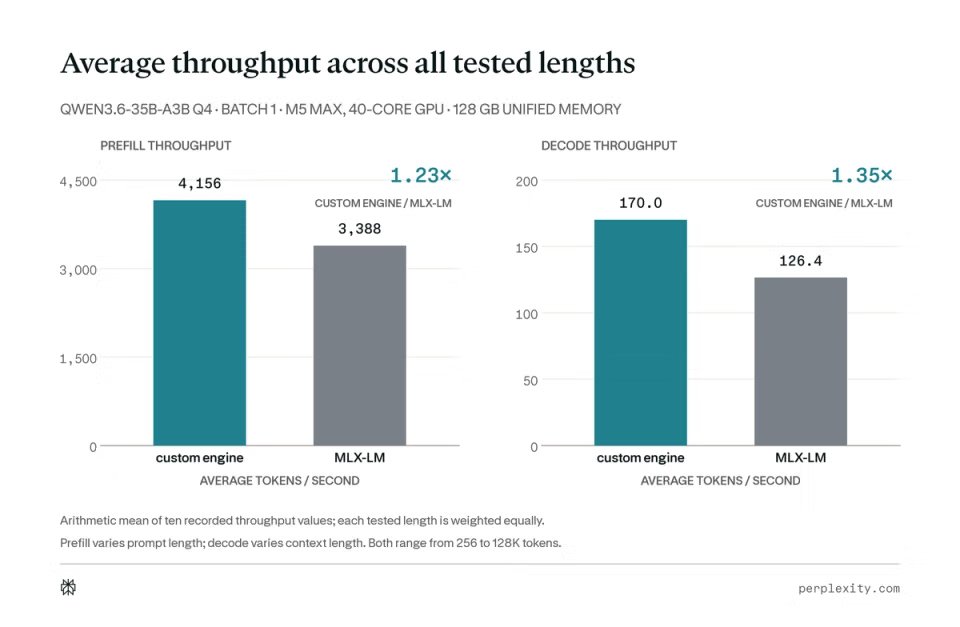
在 M5 Max MacBook Pro 上对 Qwen3.6-35B-A3B 进行基准测试,Lily 在预填充和解码吞吐量上分别比 MLX-LM 平均快 1.23 倍和 1.35 倍,同时保持输出质量。
AI推荐理由 提供了 Lily 引擎的性能数据,对在 Apple Silicon 上优化推理性能的开发者有直接参考价值。
88
浏览 11,788
点赞 60
评论 2
转发 2
正文
我们在 M5 Max MacBook Pro 上对 Qwen3.6-35B-A3B 进行了基准测试。
在十种提示长度和十种解码上下文中,Lily 比 MLX-LM 更快,平均预填充吞吐量提高 1.23 倍,解码吞吐量提高 1.35 倍,同时保持输出质量基本不变。
查看原文(中文正文为 AI 翻译)
We benchmark Qwen3.6-35B-A3B on an M5 Max MacBook Pro.
Across ten prompt lengths and ten decode contexts, Lily was faster than MLX-LM, averaging 1.23× higher prefill throughput and 1.35× higher decode throughput while keeping output quality effectively unchanged.
