AI编码
x.com ·
@meng shao(@shao__meng)
Claude Code开发者总结Effort参数使用指南:本质是验证强度,而非修正方向错误
该帖转述Claude Code开发者Thariq基于官方评测与自测得出的Effort参数使用指南。核心观点是:effort代表模型投入的计算量预算,其本质是验证强度,提高effort主要减少遗漏边界情况导致的失败,但无法修复方向或思路错误。高effort在硬件、代码审查、安全等隐藏边界情况多的领域收益较大,低/中effort更适合头脑风暴、草稿和简单改动;任务规格越详细,不同effort产出差异越小。文中还给出低、中、高、Max四档适用场景及先低effort实现、再高effort验证的工作流。
AI推荐理由 内容转述Claude Code开发者基于官方评测与自测得出的Effort参数使用指南,给出可操作结论:effort本质是验证强度,主要减少遗漏边界情况而非修正方向错误,并区分高/低effort适用领域与工作流,对使用Claude Code等Agent工具的开发者有直接参考价值;但属二手转述,未附原始评测数据,部分模型名称与基准细节无法在输入中核验,故质量分未给满分。
78
正文
'Effort' 参数到底应该怎么用?
Claude Code 开发者 [@trq212](https://x.com/trq212) 基于官方评测和亲手实验得出 “Effort 参数使用指南”。
首先看看 effort 到底是什么?
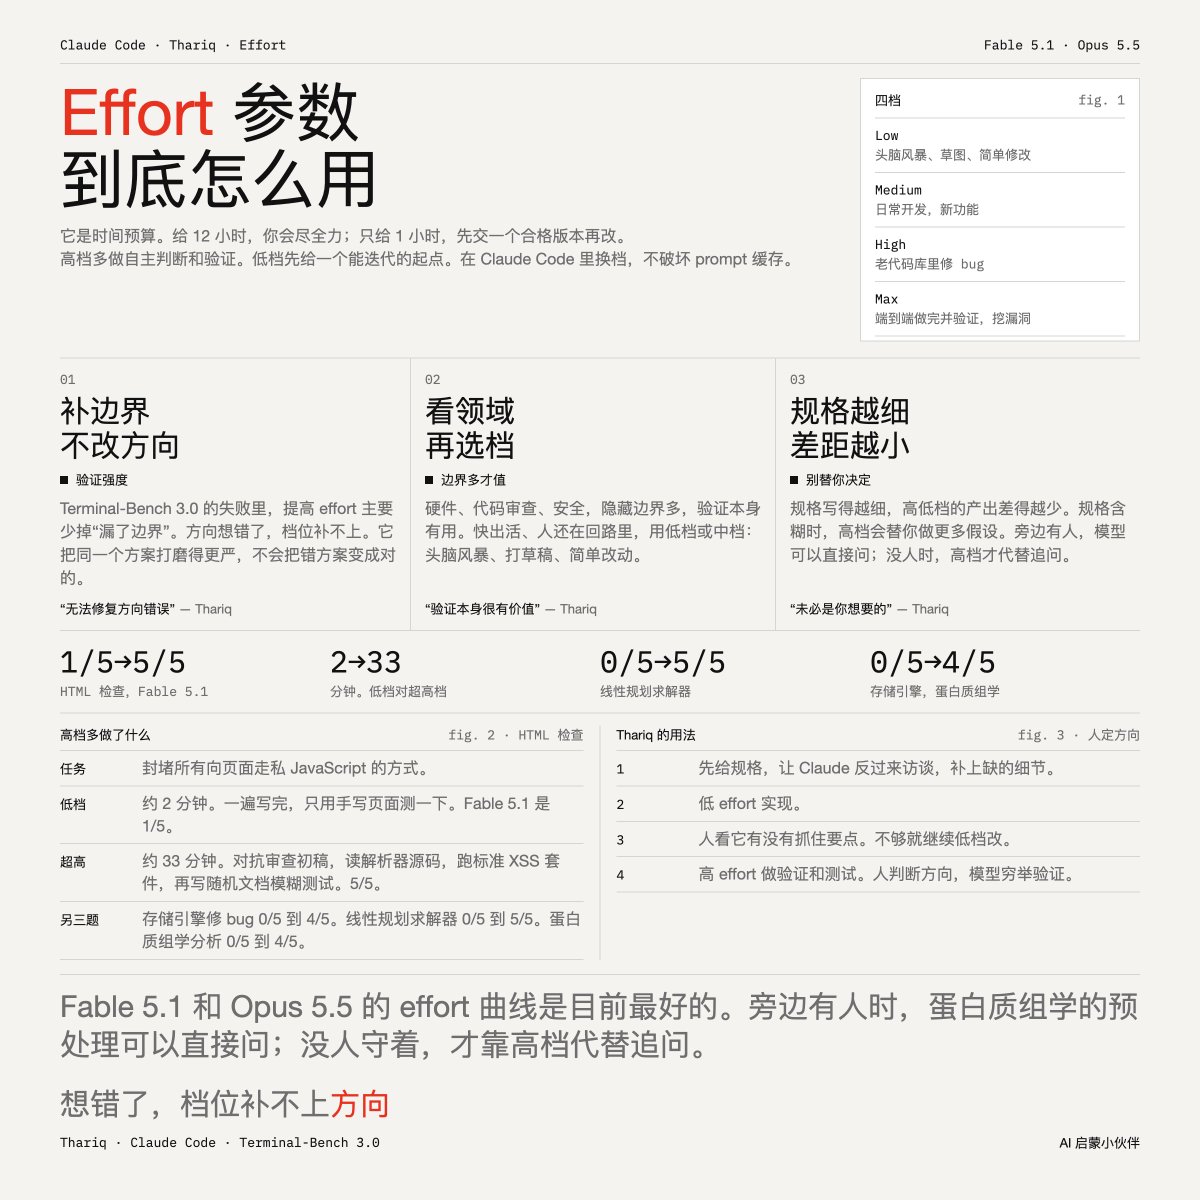
Effort 是告诉模型“你希望它为这个任务投入多少计算量”的信号。Thariq 给了一个很精准的类比:同样是做一个任务,别人给你 12 小时,你会理解为“尽全力做好”;只给你 1 小时,你会先交付一个满足要求的版本,等对方反馈再迭代。Effort 就是这个“时间预算”:高 effort 意味着模型会做更多自主判断、更多验证;低 effort 意味着快速给一个可迭代的起点。
一个重要背景:新一代模型 (Fable 5.1、Opus 5.5) 的 effort 曲线是迄今最好的,且在 Claude Code 中切换 effort 不会破坏 prompt 缓存,这正是这个功能真正可用的前提。
关键发现一:effort 的本质是“验证强度”
Thariq 通过分析 Terminal-Bench 3.0 (社区共建的终端任务基准) 的失败数据得出核心结论:
提高 effort 主要减少“遗漏边界情况”导致的失败,但无法修复“方向/思路错误”导致的失败。
换句话说,effort 不会让一个想错了方案的模型变对,它只会让模型把同一个方案打磨得更严密。这个区分是全文最有洞察力的一点。
典型证据:HTML 检查任务 (要求封堵所有向页面走私 JavaScript 的方式),Fable 5.1 从低 effort 的 1/5 提升到超高 effort 的 5/5。低 effort 下模型一遍写完、只用手写页面测一下(约 2 分钟);高 effort 下(约 33 分钟)它会对抗性审查自己的初稿、读解析器源码找 bug、跑标准 XSS 测试套件、甚至写随机文档模糊测试器。类似的还有存储引擎 bug 修复(0/5→4/5)、线性规划求解器(0/5→5/5)、蛋白质组学分析(0/5→4/5)。
关键发现二:effort 的收益因领域而异
高 effort 受益大的领域:硬件、代码审查、安全,共性是“隐藏边界情况多、验证本身很有价值”。
低/中 effort 更合适的场景:快速出活、需要人保持在决策回路里(brainstorm、打草稿、简单改动)。值得注意的是 gsea-proteomics 那个例子:如果有用户在旁边,模型本可以直接问“数据预处理用哪种方式”;无人值守时,高 effort 才能替代这种追问。
另一个反直觉发现:任务规格(spec)写得越详细,不同 effort 的产出差异越小。规格模糊时,高 effort 意味着模型替你做更多假设和决定,这未必是你想要的。
Thariq 的实际工作流
1. 给 Claude 一份规格,让它反过来访谈我,补齐缺失细节;
2. 低 effort 实现;
3. 人工审查是否抓住要点,需要时继续低 effort 迭代;
4. 高 effort 做验证和测试。
这个模式把“人擅长判断方向”和“模型擅长穷举验证”分别放在了合适的环节。
Effort 档位速查
Low - 快速响应、人在回路,比如头脑风暴、草图、简单修改
Medium - 日常开发主力档,比如新功能实现
High - 验证重要、边界情况多,比如老代码库修 bug
Max - 完全自主解决难题,比如端到端构建并验证应用、安全漏洞挖掘

Thariq@trq212
What is effort really? When do you change it it and why not just use max effort for everything?
I dove deep into this problem, looking into evals and doing my own tests and I was quite surprised by the results. [x.com/i/article/2103…](https://x.com/i/article/2103535187426709504)
[🔗 View Quoted Tweet](https://x.com/trq212/status/2103576349499855160)
💬2🔄1❤️4👀730📊3