AI编码
x.com ·
@shao__meng
斯坦福 CS146S「AI 原生软件开发」第二周:高级上下文工程与 MCP 工具调用
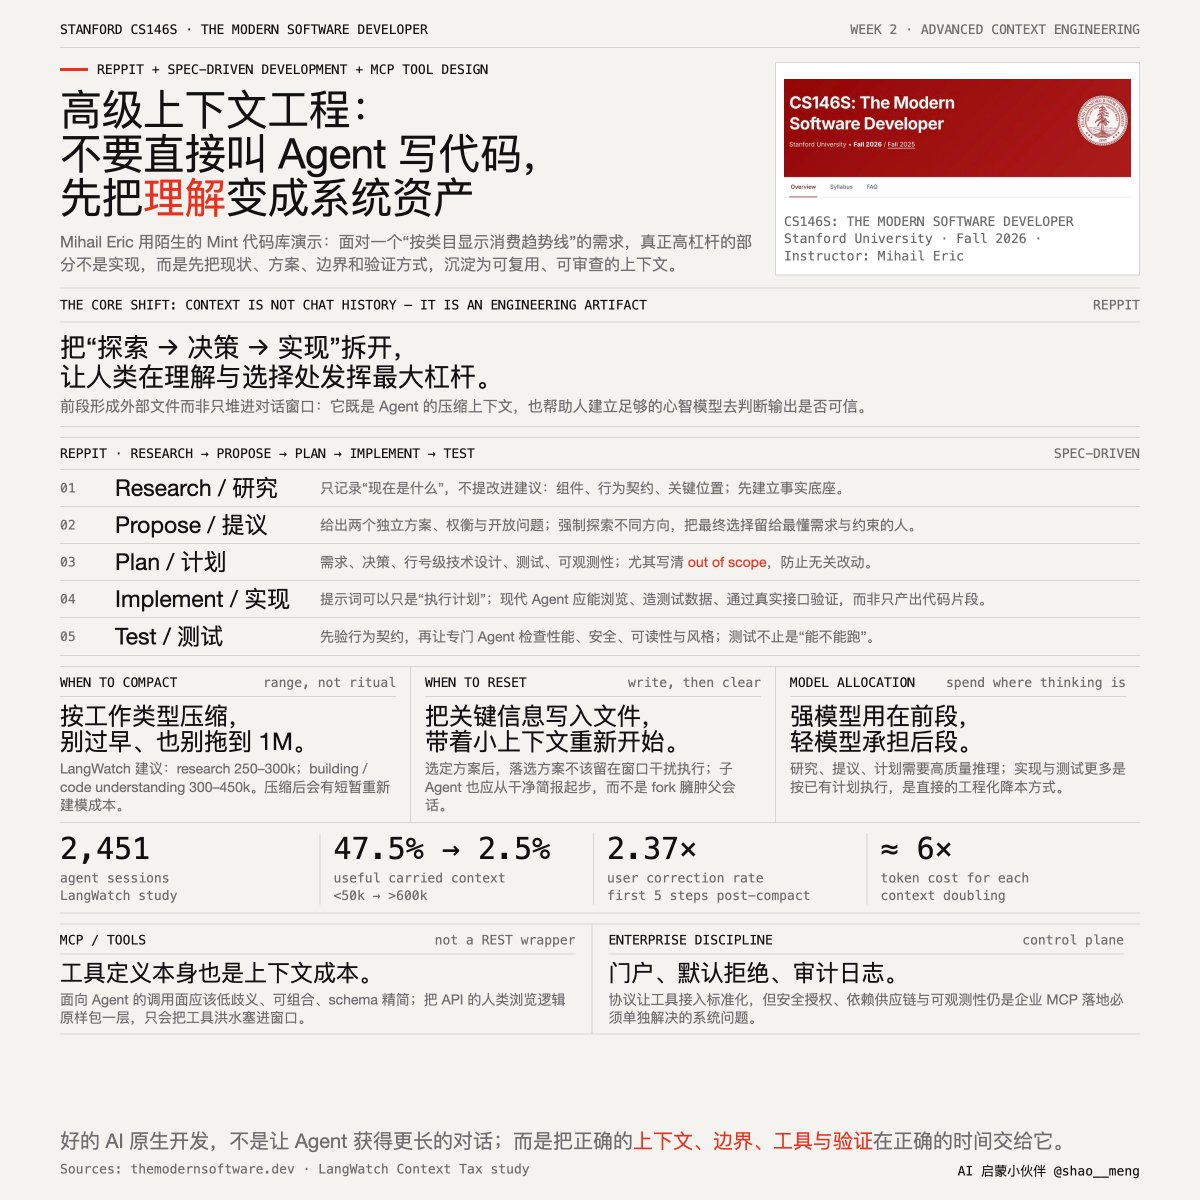
斯坦福 CS146S 第二周课程聚焦高级上下文工程与 MCP 工具调用。核心方法论 RePPIT(Research、Propose、Plan、Implement、Test)配合 spec-driven development,强调研究阶段只记录现状、提议阶段产出两个正交方案、计划阶段明确圈定范围外事项。上下文管理部分引用 LangWatch 对 2451 个 Claude Code 会话的研究:建议在 25 万–45 万 token 间压缩,压缩后 5 步内纠错率升至基线 2.37 倍;倾向清空重开而非从臃肿父会话 fork 子智能体;前段用最强模型、后段用轻量模型。MCP 部分覆盖协议模型、Cloudflare 企业级方案(门户+默认拒绝+审计日志,工具 schema 从 52 个约 9400 token 降至 2 个约 600 token)以及面向智能体的工具设计原则。生态对比 RePPIT、OpenSpec 与 Superpowers 三条规格驱动路线。
AI推荐理由
内容为斯坦福 CS146S 第二周课程(高级上下文工程、MCP 与工具调用)的详细笔记,包含 RePPIT 五步工作流、上下文压缩阈值(25万–45万 token)、压缩后纠错率升至基线 2.37 倍、Cloudflare MCP 工具 schema 从 52 个约 9400 token 收拢为 2 个约 600 token 等具体信息,并对比 OpenSpec 与 Superpowers 三条规格驱动路线,对 Agent 工作流与上下文工程实践有直接参考价值。局限:属个人转述课程内容,非官方课程材料,部分数据引自 LangWatch 研究但未给出可核验链接,star 数等数字未在正文中独立验证。
78
浏览 734
点赞 8
评论 3
转发 0
正文
斯坦福大学「AI 原生软件开发」第二周课程已公开
[@mihail\_eric](https://x.com/mihail_eric) 教授带来的这门「CS146S: The Modern Software Developer」已经进行到了第二周,主题是:高级上下文工程
[themodernsoftware.dev](https://themodernsoftware.dev/)
这周课程分为两节:
高级提示技巧 + RePPIT 框架与 SDD
MCP 与工具调用全解:理论、搭建与工具设计
# RePPIT 框架:五步工作流
RePPIT (Research, Propose, Plan, Implement, Test) and spec-driven development
本周的方法论主体,Mihail 用一个自己 vibe code 出来的 Mint(个人记账应用)克隆做现场演示,为它添加"按类目显示消费趋势线"的功能。关键设定是:他自己也没读过这个代码库的代码,以此模拟接手陌生代码的真实场景。
五步各自要点:
1. Research(研究) — 只记录"现状是什么",明确禁止提出改进建议。产出一份结构化的研究文档:代码库有哪些组件、行为契约是什么、关键代码位置在哪。这份文档有双重作用:既为后续步骤播种上下文(用压缩后的表示替代喂原始代码),也帮人自己建立足够的心理模型去鉴别智能体输出的好坏。
2. Propose(提议) — 基于研究文档,让智能体给出两个相互独立的方案(附权衡分析与开放问题)。为什么是两个?讲师用 PCA 打比方:他要的是"正交的主成分",强制智能体探索解空间的两个不同方向,更多方案收益递减,剩下的判断空间留给人。人在这两步的参与度最高:作为理解产品需求与系统约束的专家做出选择,这是当前人类杠杆最大的位置。
3. Plan(计划) — 用模板化的设计文档填充:现状、功能性与非功能性需求、设计决策与权衡、技术设计(讲师特意要求带行号,让计划接近代码级别)、测试计划、可观测性、未来考虑。其中最有价值的一节是明确圈定范围外的事项("不要碰这些,只做范围内的工作")这是防止智能体跑偏做无关改动的重要护栏。
4. Implement(实现) — 提示词几乎就是一句"执行计划"。真正值得注意的变化是:现代智能体(如 Cursor)会隐式地打开浏览器、造测试数据、通过 CSV 接口上传来验证自己刚写的功能,实现与测试正在合并为一步。若你的智能体没有此能力,可加 Playwright 之类的 MCP server 补足。
5. Test(测试) — 分两层。行为契约(上传 CSV → 看到趋势线)由智能体的浏览器交互直接验证;性能、可读性、安全性等超出行为契约的部分交给 agent 驱动的代码审查(实践中常见四五个专门化智能体各管一域,安全、性能、风格,由协调智能体汇总成一份报告)。
# 上下文管理的三个实操问题
这是现场问答中含金量最高的部分(依据为 LangWatch 对 2,451 个 Claude Code 会话的实证研究):
何时压缩(compact)? 在 25 万–45 万 token 之间执行压缩,宁可偏晚也不要太早,压缩过早的代价远高于过晚。原始研究还发现上下文利用率随窗口膨胀急剧衰减:5 万以下时利用率 47.5%,60 万以上时只剩 2.5%;而压缩后 5 步内用户纠错率会升至基线的 2.37 倍(存在"压缩后迷雾期"),所以也不能无节制地压。
何时清空重开? 演示中讲师做了一次他自认不妥的操作:选定方案后没清上下文,导致落选方案的 token 仍留在窗口里干扰执行。他的原则是倾向于清空,把关键信息写入文件,用压缩表示开新会话。另外不要从臃肿的父会话 fork 子智能体(有人因此一天烧掉 11 亿 token),应让子智能体从干净的小上下文起步。
模型怎么分配? 前段(研究/提议/计划)用最强的模型,因为思考集中在这里;后段(实现/测试)可以用轻量模型。这是一种直接的工程化降本手段。
# MCP 与工具调用
第二次课覆盖 MCP 的理论、搭建与工具设计。配套阅读勾勒出三个层次:
1. 协议本身:server/client/tool/transport 的基本模型——让智能体以标准化方式调用外部能力。
2. 工程实践:Cloudflare 的企业级方案直面 MCP 落地的四大痛点,供应链风险(本地 server 依赖未审计软件)、授权失控(员工各装各的)、工具 schema 洪水(52 个工具约 9,400 token,Code Mode 把它们收拢成 2 个工具约 600 token,降 94%)以及影子 MCP 检测。其"门户 + 默认拒绝 + 审计日志"的架构是 MCP 企业化的一套参考答案。
3. 工具设计的"人机工学":为智能体设计工具不是把 REST API 直接包一层——API 的组织逻辑服务人类浏览,而智能体需要的是低歧义、可组合、schema 精简的调用面。这与上一讲的"smart tokens"一脉相承:工具定义本身也占用上下文,也是要经营的成本。
# 生态对比:三条规格驱动路线
阅读材料中的 OpenSpec 与 Superpowers 正是 RePPIT 的工业化对照物,三者共享同一思想内核(先探索、再提案、再计划、后执行、终验证),但形态不同:
RePPIT:讲师自用一年半打磨的个人技能集,轻量、可自由改造
OpenSpec(约 6.8 万 star):以 /explore → /propose → /apply → /verify → /archive 命令固化为目录化的规格产物(proposal.md、specs/、design.md、tasks.md),强调规格随工作演进且团队与智能体对齐
Superpowers(约 30 万 star):讲师称之为"我讲的框架的强化版",一整套可组合的技能库(头脑风暴、写计划、执行计划、代码审查、TDD、系统性调试),并强制执行"测试先行、系统化而非临时起意、证据优先于声明"的纪律。讲师特别点出:这个 30 万 star 的仓库本质就是一组 SKILL.md 技能文件,这本身就是"工作流即代码"的绝佳例证。

meng shao@shao\_\_meng
[x.com/i/article/2103…](https://x.com/i/article/2103314451781001216)
[🔗 View Quoted Tweet](https://x.com/shao__meng/status/2103318959349285119)