开源工具
x.com ·
@qdrant_engine
Qdrant 案例:Lucy 在 280 万份 SEC/DART 文件上构建检索层,FinanceBench Recall@10 达 94.7%
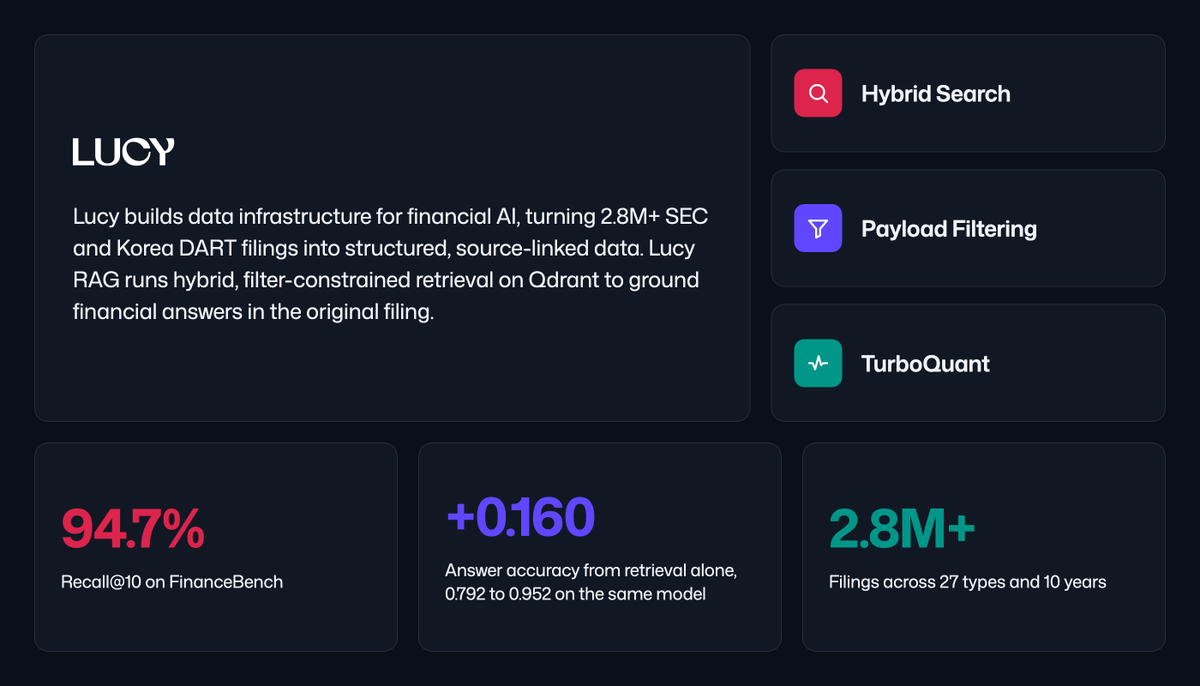
Qdrant 官方账号介绍 Lucy 的案例:基于 Qdrant 构建覆盖 280 万+ 份 SEC 与韩国 DART 文件的检索层,采用四条混合检索通道,payload 过滤在查询内部而非查询后执行。文中称在 FinanceBench 上 Recall@10 为 94.7%,在答案模型固定的条件下,仅靠检索改进带来 +0.160 的答案准确率提升,并称开源权重模型在 Lucy RAG 上表现优于使用网页搜索的前沿模型。相关细节见其博客案例页。上述指标为厂商自述,未提供第三方复现与完整评测配置。
AI推荐理由 Qdrant 官方账号披露的 Lucy 案例:在 280 万+ SEC 与韩国 DART 文件上构建检索层,采用四条混合检索通道,payload 过滤在查询内执行;给出 FinanceBench Recall@10 94.7%、固定答案模型下检索单独带来 +0.160 答案准确率,并称开源权重模型在 Lucy RAG 上优于联网搜索的前沿模型。具体指标与架构细节有参考价值,但数据来自厂商自述、缺少第三方复现,且未说明基准配置与对比口径,需谨慎看待。
72
浏览 336
点赞 8
评论 1
转发 0
正文
Lucy built a source-of-truth retrieval layer over 2.8M+ SEC and Korea DART filings.
Four hybrid lanes on Qdrant, payload filters applied inside the query, not after it.
94.7% Recall[@10](https://x.com/10) on FinanceBench.
+0.160 answer accuracy from retrieval alone, with the answer model held fixed.
An open-weight model on Lucy RAG beat frontier models searching the web.
[qdrant.tech/blog/case-stud…](https://qdrant.tech/blog/case-study-lucy/)